问题
单个自注意力头只计算一个注意力矩阵。这个矩阵捕捉一种关系——通常是在给定训练信号下使损失最小的那一种。如果你的数据里主语-谓语一致、共指、长距离话语结构和句法组块全都纠缠在一起,单个头会把它们抹成一个 softmax 分布,丢掉一半信号。
2017 年 Vaswani 论文给出的修复办法:并行运行多个注意力函数,每个都有自己的 Q、K、V 投影,然后拼接输出。每个头在维度为 d_{\text{model}} / n_{\text{heads}} 的更小子空间中运作。参数总量不变,表达能力上升。
多头注意力是 2026 年每个 Transformer 的默认配置。唯一的争论在于用多少个头,以及 key 和 value 是否共享投影(Grouped-Query Attention、Multi-Query Attention、Multi-head Latent Attention)。
概念
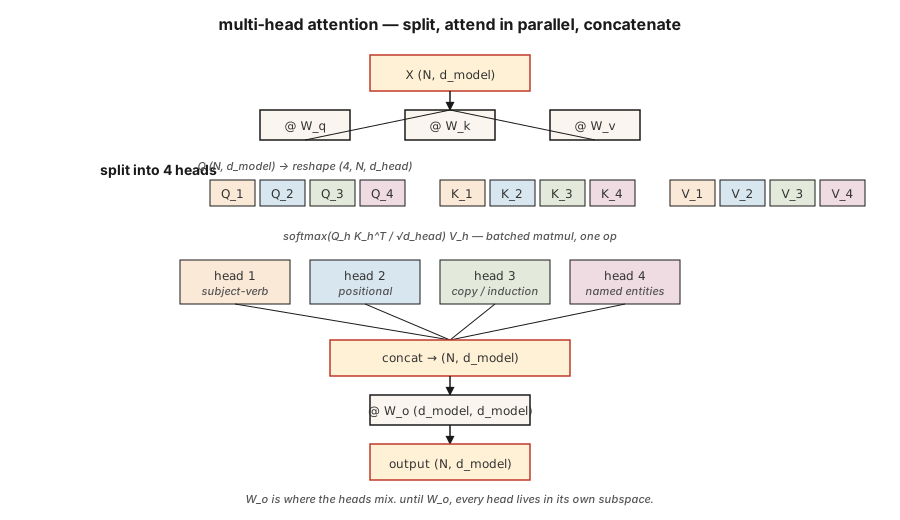
拆分。 取形状为 (N, d_model) 的 X。投影为 Q、K、V,各自形状 (N, d_model)。重塑为 (N, n_heads, d_head),其中 d_{\text{head}} = d_{\text{model}} / n_{\text{heads}}。转置为 (n_heads, N, d_head)。
并行注意。 在每个头内部运行缩放点积注意力。每个头产出 (N, d_head)。这些头在 embedding 的不同子空间上运作,在注意力计算本身期间从不交流。
拼接与投影。 把头堆叠回 (N, d_model),再乘以形状为 (d_model, d_model) 的可学习输出矩阵 W_o。W_o 是各个头得以混合的地方。
为什么有效。 每个头可以专门化,而无需与其他头争夺表示预算。2019–2024 年的探针研究显示了不同的头角色:位置头、关注前一个 token 的头、复制头、命名实体头、归纳头(归纳头是上下文学习的基础)。
2026 年的变体谱系:
| 变体 | Q 头数 | K/V 头数 | 使用者 |
|---|---|---|---|
| 多头(MHA) | N | N | GPT-2、BERT、T5 |
| 多查询(MQA) | N | 1 | PaLM、Falcon |
| 分组查询(GQA) | N | G(如 N/8) | Llama 2 70B、Llama 3+、Qwen 2+、Mistral |
| 多头潜在(MLA) | N | 压缩为低秩 | DeepSeek-V2、V3 |
GQA 是现代的默认选择,因为它把 KV cache 内存削减到原来的 1/(N/G),同时几乎保持全部质量。MLA 更进一步,把 K/V 压缩到潜在空间,在计算时再投影回来——多花 FLOPs,省下多得多的内存。
构建它
第 1 步:从已有的单头注意力拆分出头
取第 02 课的 SelfAttention,用一对 split/concat 包装它。numpy 实现见 code/main.py;逻辑如下:
pythondef split_heads(X, n_heads):
n, d = X.shape
d_head = d // n_heads
return X.reshape(n, n_heads, d_head).transpose(1, 0, 2) # (heads, n, d_head)
def combine_heads(H):
h, n, d_head = H.shape
return H.transpose(1, 0, 2).reshape(n, h * d_head)一次 reshape 加一次 transpose,没有循环。这正是 PyTorch 在 nn.MultiheadAttention 底层做的事。
第 2 步:对每个头运行缩放点积注意力
每个头拿到自己那一份 Q、K、V。注意力变成一次批量矩阵乘法:
pythondef mha_forward(X, W_q, W_k, W_v, W_o, n_heads):
Q = X @ W_q
K = X @ W_k
V = X @ W_v
Qh = split_heads(Q, n_heads) # (heads, n, d_head)
Kh = split_heads(K, n_heads)
Vh = split_heads(V, n_heads)
scores = Qh @ Kh.transpose(0, 2, 1) / np.sqrt(Qh.shape[-1])
weights = softmax(scores, axis=-1)
out = weights @ Vh # (heads, n, d_head)
concat = combine_heads(out)
return concat @ W_o, weights在真实硬件上,Qh @ Kh.transpose(...) 就是一次 bmm。GPU 看到的是单次批量矩阵乘法,形状为 (heads, N, d_head) × (heads, d_head, N) -> (heads, N, N)。增加头是免费的。
第 3 步:Grouped-Query Attention 变体
只有 key 和 value 的投影改变。Q 拿到 n_heads 组;K 和 V 拿到 n_kv_heads < n_heads 组,并被重复以对齐:
pythondef gqa_project(X, W, n_kv_heads, n_heads):
kv = split_heads(X @ W, n_kv_heads) # (kv_heads, n, d_head)
repeat = n_heads // n_kv_heads
return np.repeat(kv, repeat, axis=0) # (n_heads, n, d_head)推理时这能省内存,因为 KV cache 里只存 n_kv_heads 份,而不是 n_heads 份。Llama 3 70B 使用 64 个 query 头和 8 个 KV 头——缓存缩小到 1/8。
第 4 步:探查每个头学到了什么
在 4 个头的配置下对一句短句运行 MHA。对每个头打印 (N, N) 注意力矩阵。你会看到即使随机初始化,不同的头也会挑出不同结构——这部分是信号,部分是子空间中的旋转对称性。
使用它
在 PyTorch 中,一行版本:
pythonimport torch.nn as nn
mha = nn.MultiheadAttention(embed_dim=512, num_heads=8, batch_first=True)PyTorch 2.5+ 中的 GQA:
pythonfrom torch.nn.functional import scaled_dot_product_attention
# scaled_dot_product_attention auto-dispatches Flash Attention on CUDA.
# For GQA, pass Q of shape (B, n_heads, N, d_head) and K,V of shape
# (B, n_kv_heads, N, d_head). PyTorch handles the repeat.
out = scaled_dot_product_attention(q, k, v, is_causal=True, enable_gqa=True)用多少个头? 2026 年生产模型的经验法则:
| 模型规模 | d_model | n_heads | d_head |
|---|---|---|---|
| 小型(~125M) | 768 | 12 | 64 |
| 基础(~350M) | 1024 | 16 | 64 |
| 大型(~1B) | 2048 | 16 | 128 |
| 前沿(~70B) | 8192 | 64 | 128 |
d_head 几乎总是落在 64 或 128。它决定单个头能「看到」多少。低于 32,各个头开始与缩放因子 \sqrt{d_{\text{head}}} 较劲;高于 256,你就失去了「许多小型专家」的好处。
交付它
见 outputs/skill-mha-configurator.md。这个 skill 根据参数预算、序列长度和部署目标,为新 Transformer 推荐头数、kv 头数和投影策略。
练习
- 简单。 取
code/main.py中的 MHA,在d_model=64固定不变的情况下把n_heads从 1 改到 16。在一个合成复制任务上,画出单层微型模型的损失。更多的头是有帮助、进入平台期,还是有害? - 中等。 实现 MQA(所有 query 头共享一个 KV 头)。测量参数量相对完整 MHA 下降了多少。计算 N=2048 时推理阶段 KV cache 大小缩小了多少。
- 困难。 实现一个微型版 Multi-head Latent Attention:把 K、V 压缩到秩为
r的潜在表示,把该潜在表示存入 KV cache,在注意力计算时解压。当r为多少时,缓存内存降到完整 MHA 的 1/8 以下,同时质量与验证集 ppl 的差距保持在 1 bit 以内?
关键术语
| 术语 | 常见说法 | 实际含义 |
|---|---|---|
| Head | 「一条注意力电路」 | 一个维度为 d_{\text{head}} = d_{\text{model}} / n_{\text{heads}} 的 Q/K/V 投影,带有自己的注意力矩阵。 |
| d_head | 「头的维度」 | 每个头的隐藏宽度;生产中几乎总是 64 或 128。 |
| Split / combine | 「reshape 技巧」 | 注意力前后围绕 (N, d_model) ↔ (n_heads, N, d_head) 的 reshape + transpose。 |
| W_o | 「输出投影」 | 拼接各头之后应用的 (d_model, d_model) 矩阵;各头在此混合。 |
| MQA | 「一个 KV 头」 | Multi-Query Attention:单个共享的 K/V 投影。KV cache 最小,有一定质量损失。 |
| GQA | 「Llama 2 以来的默认」 | Grouped-Query Attention,n_kv_heads < n_heads;重复以匹配 Q。 |
| MLA | 「DeepSeek 的技巧」 | Multi-head Latent Attention:K、V 压缩为低秩潜在表示,在注意力计算时解压。 |
| Induction head | 「上下文学习背后的电路」 | 一对头,检测之前的出现位置并复制其后的内容。 |
延伸阅读
- Vaswani 等(2017). Attention Is All You Need §3.2.2 —— 原始多头规范。
- Shazeer(2019). Fast Transformer Decoding: One Write-Head is All You Need —— MQA 论文。
- Ainslie 等(2023). GQA: Training Generalized Multi-Query Transformer Models from Multi-Head Checkpoints —— 如何在训练后把 MHA 转换为 GQA。
- DeepSeek-AI(2024). DeepSeek-V2 Technical Report —— MLA 以及它为何在缓存内存上胜过 MHA/GQA。
- Olsson 等(2022). In-context Learning and Induction Heads —— 从机制角度观察头到底在做什么。
示意图共 1 张