问题
稠密 Transformer 在推理时的 FLOPs 等于其参数量(前向传播乘以 2)。扩大稠密模型,每个 token 都要付全款。到 2024 年,前沿模型撞上了算力墙:要想真正变聪明,每个 token 需要指数级增加的 FLOPs。
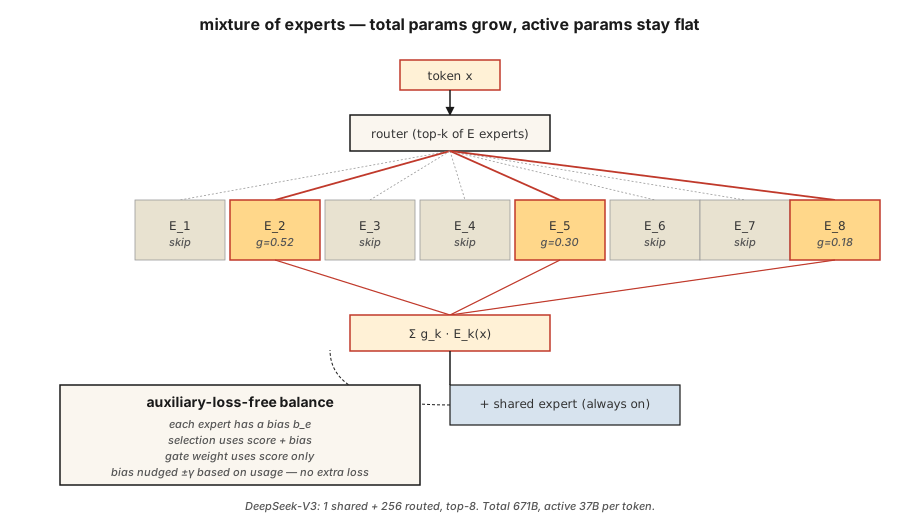
混合专家(MoE)打断了这条链路。把每个 FFN 替换为 E 个独立专家,再加一个为每个 token 挑选 k 个专家的路由器。总参数 = E \times \text{FFN size}。每个 token 的激活参数 = k \times \text{FFN size}。2026 年的典型配置:E=256,k=8。存储随 E 扩展,计算随 k 扩展。
2026 年的前沿几乎全是 MoE:DeepSeek-V3(总参数 671B,激活 37B)、Mixtral 8×22B、Qwen2.5-MoE、Llama 4、Kimi K2、gpt-oss。在 Artificial Analysis 的独立排行榜上,前十的开源模型全部是 MoE。
概念
替换 FFN
稠密 Transformer 块:
h = x + attn(norm(x))
h = h + FFN(norm(h))MoE 块:
h = x + attn(norm(x))
scores = router(norm(h)) # (N_tokens, E)
top_k = argmax_k(scores) # pick k of E per token
h = h + sum_{e in top_k}(
gate(scores[e]) * Expert_e(norm(h))
)每个专家都是一个独立的 FFN(通常是 SwiGLU)。路由器是一个线性层。每个 token 挑选自己的 k 个专家,得到它们输出的门控混合。
负载均衡问题
如果路由器把 90% 的 token 都送进专家 3,其他专家就会饿死。人们尝试过三种修正:
- 辅助负载均衡损失(Switch Transformer、Mixtral)。加入与专家使用量方差成正比的惩罚项。有效,但引入一个超参数和第二条梯度信号。
- 专家容量 + token 丢弃(早期 Switch)。每个专家最多处理 C \times N/E 个 token;溢出的 token 跳过该层。损害质量。
- 无辅助损失的均衡(DeepSeek-V3)。加入一个可学习的逐专家偏置,偏移路由器的 top-k 选择。偏置在训练损失之外更新。主目标不受惩罚。这是 2024 年的重大突破。
DeepSeek-V3 的做法:每个训练步之后,对每个专家检查其使用量高于还是低于目标。把偏置微调 ±γ。选择时使用 scores + bias。用于门控的专家概率仍是原始的 scores,保持不变。这样就解耦了路由与门控权重。
共享专家
DeepSeek-V2/V3 还把专家分为共享和路由两类。每个 token 都经过所有共享专家。路由专家通过 top-k 选取。共享专家捕捉通用知识;路由专家负责专精。V3 运行 1 个共享专家,加上 256 个路由专家中的 top-8。
细粒度专家
经典 MoE(GShard、Switch):每个专家与完整 FFN 一样宽。E 较小(8–64),k 较小(1–2)。
现代细粒度 MoE(DeepSeek-V3、Qwen-MoE):每个专家更窄(FFN 大小的 1/8)。E 很大(256 以上),k 更大(8 以上)。总参数相同,但组合数量增长快得多。每个 token 有 \binom{256}{8} \approx 400 万亿种可能的「专家」组合。质量上升,延迟持平。
成本画像
每个 token、每个层:
| 配置 | 每 token 激活参数 | 总参数 |
|---|---|---|
| Mixtral 8×22B | ~39B | 141B |
| Llama 3 70B(稠密) | 70B | 70B |
| DeepSeek-V3 | 37B | 671B |
| Kimi K2(MoE) | ~32B | 1T |
DeepSeek-V3 在几乎每项基准上都胜过 Llama 3 70B(稠密),同时每个 token 的激活 FLOPs 更少。参数越多 = 知识越多。激活 FLOPs 越多 = 每个 token 的计算越多。MoE 把两者解耦了。
代价:显存
无论哪些专家被激活,所有专家都要驻留在 GPU 上。671B 模型的 fp16 权重需要约 1.3 TB 显存。前沿 MoE 部署需要专家并行——把专家分片到多块 GPU 上,并跨网络路由 token。延迟由 all-to-all 通信主导,而不是矩阵乘法。
构建它
见 code/main.py。一个纯标准库的紧凑 MoE 层,包含:
n_experts=8个类 SwiGLU 专家(为演示起见,每个只有一个线性层)- top-k=2 路由
- softmax 归一化的门控权重
- 通过逐专家偏置实现的无辅助损失均衡
第 1 步:路由器
pythondef route(hidden, W_router, top_k, bias):
scores = [sum(h * w for h, w in zip(hidden, W_router[e])) for e in range(len(W_router))]
biased = [s + b for s, b in zip(scores, bias)]
top_idx = sorted(range(len(biased)), key=lambda i: -biased[i])[:top_k]
# softmax over ORIGINAL scores of the chosen experts
chosen = [scores[i] for i in top_idx]
m = max(chosen)
exps = [math.exp(c - m) for c in chosen]
s = sum(exps)
gates = [e / s for e in exps]
return top_idx, gates偏置影响的是选择,而不是门控权重。这就是 DeepSeek-V3 的诀窍——偏置纠正负载失衡,却不左右模型的预测。
第 2 步:让 100 个 token 通过路由器
统计每个专家被激活的频率。没有偏置时,使用量是偏斜的。加入偏置更新循环(对过度使用的专家 -γ,对使用不足的 +γ),使用量在几次迭代后收敛到均匀分布。
第 3 步:参数量对比
打印一个 MoE 配置的「稠密等价物」。DeepSeek-V3 形状:256 个路由专家 + 1 个共享专家,8 个激活,d_model=7168。总参数量令人咋舌。激活参数量只有稠密 Llama 3 70B 的七分之一。
使用它
HuggingFace 加载:
pythonfrom transformers import AutoModelForCausalLM, AutoTokenizer
model = AutoModelForCausalLM.from_pretrained("mistralai/Mixtral-8x22B-v0.1")2026 年的生产推理:vLLM 原生支持 MoE 路由。SGLang 拥有最快的专家并行路径。两者都自动处理 top-k 选择和专家并行。
什么时候选 MoE:
- 想要前沿质量,同时降低每 token 的推理成本。
- 有足够的显存或专家并行基础设施。
- 负载是 token 密集型(聊天、代码),而不是上下文密集型(长文档)。
什么时候不选 MoE:
- 边缘部署——为任何一点激活计算都要付全部存储成本。
- 延迟敏感的单用户服务——专家路由带来额外开销。
- 小模型(<7B)——MoE 的质量优势只在超过某个算力阈值(约 6B 激活参数)后才会出现。
交付它
见 outputs/skill-moe-configurator.md。该 skill 依据参数预算、训练 token 数和部署目标,为新 MoE 选择 E、k 以及共享专家布局。
练习
- 简单。 运行
code/main.py。观察无辅助损失的偏置更新如何在 50 次迭代中让专家使用量趋于均匀。 - 中等。 把可学习路由器换成基于哈希的路由器(确定性,不学习)。比较质量与均衡性。为什么可学习路由器更好?
- 困难。 实现 GRPO 风格的「rollout 匹配路由」(DeepSeek-V3.2 的技巧):记录推理时哪些专家被激活,在梯度计算时强制使用同样的路由。在玩具策略梯度设置中测量其效果。
关键术语
| 术语 | 通俗说法 | 实际含义 |
|---|---|---|
| 专家 | 「众多 FFN 中的一个」 | 一个独立的前馈网络;其参数专门服务于 FFN 计算的一个稀疏切片。 |
| 路由器 | 「门控」 | 一个很小的线性层,为每个 token 对每个专家打分;再做 top-k 选择。 |
| Top-k 路由 | 「每个 token 激活 k 个专家」 | 每个 token 的 FFN 计算恰好经过 k 个专家,按门控权重加权。 |
| 辅助损失 | 「负载均衡惩罚」 | 一个额外的损失项,惩罚偏斜的专家使用情况。 |
| 无辅助损失 | 「DeepSeek-V3 的技巧」 | 只用逐专家偏置影响路由器的选择来实现均衡;不产生额外梯度。 |
| 共享专家 | 「常开」 | 每个 token 都会经过的额外专家;捕捉通用知识。 |
| 专家并行 | 「按专家分片」 | 把不同专家分布到不同 GPU;跨网络路由 token。 |
| 稀疏性 | 「激活参数 < 总参数」 | 比例 k \times \text{expert size} / (E \times \text{expert size});DeepSeek-V3 为 37/671 ≈ 5.5%。 |
延伸阅读
- Shazeer et al. (2017). Outrageously Large Neural Networks: The Sparsely-Gated Mixture-of-Experts Layer —— 这个想法的源头。
- Fedus, Zoph, Shazeer (2022). Switch Transformer: Scaling to Trillion Parameter Models with Simple and Efficient Sparsity —— Switch,经典的 MoE。
- Jiang et al. (2024). Mixtral of Experts —— Mixtral 8×7B。
- DeepSeek-AI (2024). DeepSeek-V3 Technical Report —— MLA + 无辅助损失 MoE + MTP。
- Wang et al. (2024). Auxiliary-Loss-Free Load Balancing Strategy for Mixture-of-Experts —— 基于偏置的均衡论文。
- Dai et al. (2024). DeepSeekMoE: Towards Ultimate Expert Specialization in Mixture-of-Experts Language Models —— 本课路由器使用的细粒度加共享专家拆分。
- Kim et al. (2022). DeepSpeed-MoE: Advancing Mixture-of-Experts Inference and Training —— 共享专家原始论文。
示意图共 1 张