问题
当你拥有 C FLOPs 的训练算力、想要得到最好的模型时,面前有两个旋钮:
- 参数量(N)多大? 模型越大,容量越高。
- 训练 token 数(D)多少? 数据越多,容量利用越充分。
FLOPs 大致按 6 × N × D 扩展。你可以把 N 调高、D 调低,也可以反过来。哪种更好?
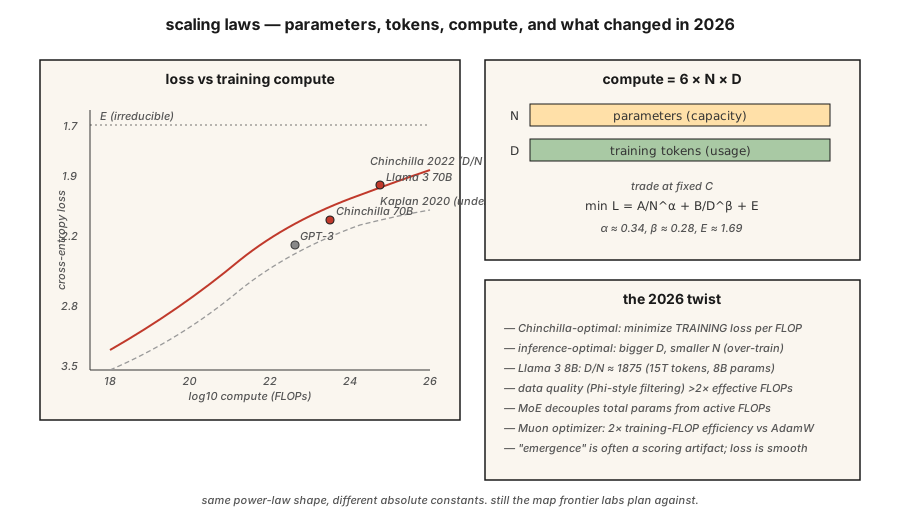
2022 年之前,答案是「使劲推高 N」。GPT-3(2020)有 175B 参数,在约 300B token 上训练,比例约每个参数 1.7 个 token。Kaplan 的缩放定律支持这一结论。
Hoffmann 等人(2022)训练了一组名为 Chinchilla 的小模型家族,发现了不同的东西:最优比例接近每个参数 20 个 token。GPT-3 的训练量不足达 10 倍。Chinchilla(70B 参数、1.4T token)在全部基准上击败 GPT-3(175B、300B token),推理成本还低 2.5 倍。
2026 年是 Chinchilla 的世界——但有一个重要转折。Llama 3 8B 在 15 万亿 token 上训练,比例是每个参数 1,875 个 token,达到 Chinchilla 最优的 94 倍。对于要大规模使用的模型,推理成本比训练成本更重要,因此为了更小的可部署足迹而「过度训练」(over-training,超过 Chinchilla 比例)是 2026 年的默认做法。
概念
Hoffmann 定律
来自 Chinchilla 论文,损失服从:
- N = 参数量(不含 embedding)。
- D = 训练 token 数。
- \alpha \approx 0.34,\beta \approx 0.28(大致对称)。
- E \approx 1.69,不可约的损失下限。
- A \approx 406,B \approx 411。
两项随着规模扩展相互制约。在固定算力(C = 6ND)下对 N 求导并求解:
计算最优:每个参数 20 个 token。
为什么仍要过度训练
Chinchilla 最优最小化了每个训练 FLOP 的训练损失。但训练成本只付一次,推理成本却永远要付。
对于一个每月服务一万亿 token 的聊天机器人,推理主导总成本。Llama 的做法是:更小的模型,训练更久。8B 模型用 15T token 训练,是深度为推理优化的:
- 能跑在消费级 GPU 上。
- 延迟只是 70B Chinchilla 最优模型的一小部分。
- 对大多数任务,质量已经足够接近。
DeepMind 2024 年的论文(《Over-training is the new optimal》)将这一点形式化。对于推理主导的工作负载,合适的比例更接近每参数 100–500 个 token,具体取决于服务量。
涌现 vs 平滑
有一种说法:某些能力(算术、多步推理、遵循思维链)会在某个规模上突然「涌现」。
Schaeffer 等人(2023)认为这是测量假象:涌现指标使用不连续的评分方式(精确匹配、阈值准确率),掩盖了底层 logit 的平滑改进。连续指标(交叉熵)显示的是平滑曲线。
2026 年的共识是:通过连续损失做出的预测是可靠的。基准分数跳变往往是评分器假象。预算规划应基于连续指标。
2026 年的图景
缩放定律依然有效,但是:
| 因素 | 改变了什么 |
|---|---|
| 数据质量 | 精选「好」token(Phi 式做法)可将曲线平移超过 2 倍有效算力 |
| MoE | 总参数与激活 FLOPs 解耦;缩放定律按每激活 FLOP 计算 |
| 后训练 | 某些能力(指令遵循、代码)随 SFT+RLHF 的变化大于预训练 |
| 多模态 | 图像 + 文本 token 一起扩展;每种模态有各自的曲线 |
| 合成数据 | 模型生成训练数据;有效算力可以复利增长 |
Muon 优化器(Kimi Moonlight,2024)在同等数据下展示了相对 AdamW 约 2 倍的有效算力增益。2026 年一些训练运行默认使用 Muon。它改变的是缩放定律中的绝对常数,而不是曲线形状。
构建它
见 code/main.py。我们实现 Chinchilla 损失方程,并在若干算力预算下求解计算最优的 (N, D)。
第 1 步:Chinchilla 损失
pythondef chinchilla_loss(N, D, A=406.4, B=410.7, alpha=0.34, beta=0.28, E=1.69):
return A / N ** alpha + B / D ** beta + E在固定 C = 6ND 下,把 L 画成 (N, D) 上的等高线图,找到最小值。
第 2 步:计算最优前沿
对从 1e17 到 1e25 FLOPs 的算力预算,找到在 6ND = C 约束下使损失最小的 (N, D)。验证比例 D/N \approx 20。
第 3 步:过度训练的成本
计算训练一个小 10 倍的模型(N 为最优值的 1/10,D 为最优值的 10 倍)所多付出的损失。同时报告换来的推理 FLOP 节省(与 N 成正比)。
第 4 步:与真实模型对比
填入 GPT-3、Chinchilla、Llama 3 8B、DeepSeek-V3(激活参数)已知的 (N, D) 对,对比预测损失与报告损失。
使用它
你不太可能亲自训练前沿模型。但缩放定律告诉你:
- 你的微调数据够不够。 如果任务专属数据低于基础模型每参数 20 个 token,就要预期在某个损失下限处饱和。
- 该不该选更大的基础模型。 如果你把所有预算都花在推理上,宁愿选一个更小、训练更久的模型。
- 收益从哪里开始递减。 超过 Chinchilla 最优 1000 倍之后,log 损失的变化已接近噪声。
2026 年的研究轨迹:
- 数据受限区间。 网络上高质量 token 数量有限(过滤后英文约 5–10 万亿)。前沿预训练正逼近这个上限。合成数据、多语言、多模态,以及用 RLHF 扩展的微调,是接下来的杠杆。
- 算力倍增技巧。 Muon 优化器、MoE、更好的数据精选——每一项都改变绝对常数,而不是渐近线。
- RL 的缩放定律。 仍是开放问题。早期证据表明 RL 样本服从幂律,但指数与预训练大不相同。
交付它
见 outputs/skill-training-budget-estimator.md。该技能根据给定算力预算、部署约束和目标损失,为新的训练运行挑选 (N, D, hours, GPU)。
练习
- 简单。 运行
code/main.py。打印算力预算1e20、1e22、1e24下的 Chinchilla 最优 (N, D)。与真实模型表对比。 - 中等。 实现 Hoffmann 定律中「损失作为算力的函数」的曲线。画出计算最优前沿的损失 vs
log10(C)。找出定律预测何时需要 >10^{28} FLOPs 才能再降低 0.1 的交叉熵。 - 困难。 在 5 个微型模型(10 万到 1000 万参数)上,用同一数据集拟合你自己的缩放定律。估计 \alpha 和 E。你的指数与已发表的结果吻合得如何?
关键术语
| 术语 | 人们怎么说 | 实际含义 |
|---|---|---|
| 参数(N) | 「模型大小」 | 不含 embedding 的权重数量;决定容量。 |
| Token 数(D) | 「训练数据」 | 训练中见到的 token 数量;决定参数被利用得多充分。 |
| 算力(C) | 「花掉的 FLOPs」 | 标准 Transformer 约为 6 × N × D。 |
| Chinchilla 最优 | 「D/N ≈ 20」 | 使预训练每 FLOP 损失最小的比例。 |
| 过度训练 | 「超过 Chinchilla」 | 多花训练 FLOPs 以节省推理 FLOPs;D/N >> 20。 |
| 不可约损失 | 「下限」 | 缩放定律中的 E 项;数据本身的熵。 |
| 涌现能力 | 「规模上的突变」 | 往往是评分器假象;连续损失是平滑的。 |
| 有效算力 | 「训练效率倍数」 | 更好的数据 / 优化器 / 架构会放大一个 FLOP 能走多远。 |
延伸阅读
- Kaplan et al. (2020). Scaling Laws for Neural Language Models —— 第一篇缩放定律论文;训练不足。
- Hoffmann et al. (2022). Training Compute-Optimal Large Language Models —— Chinchilla。
- Schaeffer et al. (2023). Are Emergent Abilities of Large Language Models a Mirage? —— 涌现是测量假象。
- Sardana, Frankle (2024). Beyond Chinchilla-Optimal: Accounting for Inference in Language Model Scaling Laws —— 为什么 Llama 的过度训练适合其工作负载。
- Jordan et al. (2024). Muon: An optimizer for hidden layers in neural networks —— 2 倍算力倍增器。
示意图共 1 张