问题
Q-learning 和 DQN 参数化的是价值函数。你用 argmax Q 选动作。这对离散动作和离散状态没问题。当动作连续时(在 10 维力矩上怎么做 argmax?)或者当你想要随机策略时(argmax 按构造就是确定性的),它就失效了。
策略梯度改为参数化策略。\pi_\theta(a \mid s) 是一个输出动作分布的神经网络。从它采样来行动。计算期望回报对 \theta 的梯度。沿上坡走。没有 argmax,没有贝尔曼递归。只是对 J(\theta) = \mathbb E_{\pi_\theta}[G] 做梯度上升。
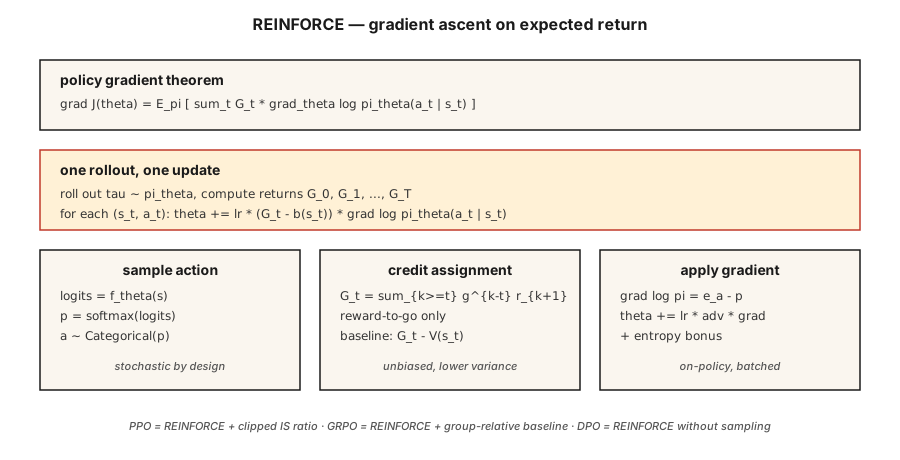
REINFORCE 定理(Williams 1992)告诉你这个梯度是可计算的:\nabla J(\theta) = \mathbb E_\pi[ G \cdot \nabla_\theta \log \pi_\theta(a \mid s) ]。跑一个回合。计算回报。每一步都乘以 \nabla \log \pi_\theta(a \mid s)。取平均。梯度上升。完成。
2026 年每个 LLM-RL 算法——PPO、DPO、GRPO——都是 REINFORCE 的细化。把它练到手指记住,是本阶段余下内容的前提,也是第 10 阶段 · 07(RLHF 实现)与第 10 阶段 · 08(DPO)的前提。
概念
策略梯度定理。 对任何由 \theta 参数化的策略 \pi_\theta:
其中 G_t = \sum_{k=t}^{T} \gamma^{k-t} r_{k+1} 是从第 t 步开始的折扣回报。期望是对从 \pi_\theta 采样的完整轨迹 \tau 取的。
证明很短。 在期望下对 J(\theta) = \sum_\tau P(\tau; \theta) G(\tau) 求导。使用 \nabla P(\tau; \theta) = P(\tau; \theta) \nabla \log P(\tau; \theta)(对数导数技巧)。分解 \log P(\tau; \theta) = \sum \log \pi_\theta(a_t \mid s_t) + \text{environment terms that do not depend on } \theta。环境项消失。两行代数就得到定理。
方差缩减技巧。 原始 REINFORCE 的方差极其可怕——回报有噪声,\nabla \log \pi 有噪声,两者相乘噪声更大。两个标准修复:
- 基线减法。 用 G_t - b(s_t) 替代 G_t,其中 b(s_t) 是任何不依赖 a_t 的基线。因为 \mathbb{E}[b(s_t) \cdot \nabla \log \pi(a_t \mid s_t)] = 0,所以无偏。典型选择:b(s_t) = \hat{V}(s_t),由 critic 学出 → actor-critic(第 07 课)。
- Reward-to-go。 把 \sum_t G_t \cdot \nabla \log \pi_\theta(a_t \mid s_t) 换成 \sum_t G_t^{\text{from } t} \cdot \nabla \log \pi_\theta(a_t \mid s_t)。对给定动作只有未来回报有意义——过去的奖励只贡献零均值噪声。
合起来得到:
这就是带基线的 REINFORCE——A2C(第 07 课)与 PPO(第 08 课)的直系祖先。
Softmax 策略参数化。 对离散动作,标准选择:
其中 f_\theta 是任何为每个动作输出分数的神经网络。梯度有干净的形式:
即,所选动作的分数减去它在策略下的期望值。
连续动作的高斯策略。 \pi_\theta(a \mid s) = N(\mu_\theta(s), \sigma_\theta(s))。\nabla \log N(a; \mu, \sigma) 有闭式解。第 9 阶段 · 07 的 SAC 需要的就这些。
构建它
第 1 步:softmax 策略网络
pythondef policy_logits(theta, state_features):
return [dot(theta[a], state_features) for a in range(N_ACTIONS)]
def softmax(logits):
m = max(logits)
exps = [exp(l - m) for l in logits]
Z = sum(exps)
return [e / Z for e in exps]对表格型环境使用线性策略(每个动作一个权重向量)。Atari 上换成 CNN,保留 softmax 头。
第 2 步:采样与对数概率
pythondef sample_action(probs, rng):
x = rng.random()
cum = 0
for a, p in enumerate(probs):
cum += p
if x <= cum:
return a
return len(probs) - 1
def log_prob(probs, a):
return log(probs[a] + 1e-12)第 3 步:记录对数概率的轨迹采样
pythondef rollout(theta, env, rng, gamma):
trajectory = []
s = env.reset()
while not done:
logits = policy_logits(theta, s)
probs = softmax(logits)
a = sample_action(probs, rng)
s_next, r, done = env.step(s, a)
trajectory.append((s, a, r, probs))
s = s_next
return trajectory第 4 步:REINFORCE 更新
pythondef reinforce_step(theta, trajectory, gamma, lr, baseline=0.0):
returns = compute_returns(trajectory, gamma)
for (s, a, _, probs), G in zip(trajectory, returns):
advantage = G - baseline
grad_log_pi_a = [-p for p in probs]
grad_log_pi_a[a] += 1.0
for i in range(N_ACTIONS):
for j in range(len(s)):
theta[i][j] += lr * advantage * grad_log_pi_a[i] * s[j]梯度 \nabla \log \pi(a \mid s) = e_a - \pi(\cdot \mid s)(a 的 one-hot 减去概率)是 softmax 策略梯度的核心。把它刻进肌肉记忆。
第 5 步:基线
用最近回合中 G 的滑动平均,就足以把方差降到让 4×4 GridWorld 跑起来;约 500 个回合收敛。把基线升级为学出来的 \hat{V}(s),你就得到 actor-critic。
常见陷阱
- 梯度爆炸。 回报可能很大。在乘以 \nabla \log \pi 之前,始终在一个 batch 内把 G 归一化到
~N(0, 1)。 - 熵坍缩。 策略过早收敛到近乎确定的动作,停止探索,卡住。修复:在目标里加熵奖励 \beta \cdot H(\pi(\cdot \mid s))。
- 高方差。 原始 REINFORCE 需要数千个回合。critic 基线(第 07 课)或 TRPO/PPO 的信任域(第 08 课)是标准修复。
- 样本效率低。 同策略意味着每次更新后丢弃所有转移。通过重要性采样做离策略修正能找回数据,代价是方差(PPO 的 ratio 就是裁剪的 IS 权重)。
- 非平稳梯度。 100 个回合前的同一梯度使用的是旧 \pi。同策略方法每隔几次轨迹采样就更新,原因正在于此。
- 信用分配。 不用 reward-to-go,过去的奖励只贡献噪声。永远使用 reward-to-go。
使用它
2026 年,REINFORCE 很少直接运行,但它的梯度公式无处不在:
| 用例 | 派生方法 |
|---|---|
| 连续控制 | 带高斯策略的 PPO / SAC |
| LLM RLHF | 带 KL 惩罚的 PPO,运行在 token 级策略上 |
| LLM 推理(DeepSeek) | GRPO——带组相对基线的 REINFORCE,无 critic |
| 多 Agent | 集中式 critic 的 REINFORCE(MADDPG、COMA) |
| 离散动作机器人 | A2C、A3C、PPO |
| 仅偏好设置 | DPO——把 REINFORCE 改写成偏好似然损失,无需采样 |
当你在 2026 年的训练脚本里读到 loss = -advantage * log_prob,那就是带基线的 REINFORCE。整篇论文(DPO、GRPO、RLOO)都是在这一行之上做方差缩减技巧。
交付它
保存为 outputs/skill-policy-gradient-trainer.md:
markdown---
name: policy-gradient-trainer
description: Produce a REINFORCE / actor-critic / PPO training config for a given task and diagnose variance issues.
version: 1.0.0
phase: 9
lesson: 6
tags: [rl, policy-gradient, reinforce]
---
Given an environment (discrete / continuous actions, horizon, reward stats), output:
1. Policy head. Softmax (discrete) or Gaussian (continuous) with parameter counts.
2. Baseline. None (vanilla), running mean, learned `V̂(s)`, or A2C critic.
3. Variance controls. Reward-to-go on by default, return normalization, gradient clip value.
4. Entropy bonus. Coefficient β and decay schedule.
5. Batch size. Episodes per update; on-policy data freshness contract.
Refuse REINFORCE-no-baseline on horizons > 500 steps. Refuse continuous-action control with a softmax head. Flag any run with `β = 0` and observed policy entropy < 0.1 as entropy-collapsed.练习
- 简单。 在 4×4 GridWorld 上用线性 softmax 策略实现 REINFORCE。不用基线训练 1,000 个回合。画出学习曲线;测量方差(回报的标准差)。
- 中等。 加入滑动平均基线。再训练一次。比较样本效率与方差。基线把收敛所需步数降低了多少?
- 困难。 加入熵奖励 \beta \cdot H(\pi)。扫描 \beta \in \lbrace 0, 0.01, 0.1, 1.0 \rbrace。画出最终回报与策略熵。这个任务上的甜点在哪里?
关键术语
| 术语 | 常被怎么说 | 实际含义 |
|---|---|---|
| Policy gradient | 「直接训练策略」 | \nabla J(\theta) = \mathbb{E}[G \cdot \nabla \log \pi_\theta(a \mid s)];由对数导数技巧推出。 |
| REINFORCE | 「最早的 PG 算法」 | Williams(1992);蒙特卡洛回报乘以对数策略梯度。 |
| Log-derivative trick | 「得分函数估计器」 | \nabla P(\tau;\theta) = P(\tau;\theta) \cdot \nabla \log P(\tau;\theta);让期望的梯度变得可算。 |
| Baseline | 「方差缩减」 | 从 G 中减去的任意 b(s);因为 \mathbb{E}[b \cdot \nabla \log \pi] = 0,所以无偏。 |
| Reward-to-go | 「只算未来回报」 | 用 G_t^{\text{from } t} 代替完整的 G_0;正确且方差更低。 |
| Entropy bonus | 「鼓励探索」 | +\beta \cdot H(\pi(\cdot \mid s)) 项防止策略坍塌。 |
| On-policy | 「用刚看到的数据训练」 | 梯度期望是针对当前策略取的——不能直接复用旧数据。 |
| Advantage | 「比平均水平好多少」 | A(s, a) = G(s, a) - V(s);带基线 REINFORCE 所乘的有符号量。 |
延伸阅读
- Williams (1992). Simple Statistical Gradient-Following Algorithms for Connectionist Reinforcement Learning —— 原始 REINFORCE 论文。
- Sutton et al. (2000). Policy Gradient Methods for Reinforcement Learning with Function Approximation —— 带函数逼近的现代策略梯度定理。
- Sutton & Barto (2018). Ch. 13 — Policy Gradient Methods —— 教科书讲述。
- OpenAI Spinning Up — VPG / REINFORCE —— 清晰的教学式阐述,附 PyTorch 代码。
- Peters & Schaal (2008). Reinforcement Learning of Motor Skills with Policy Gradients —— 方差缩减与自然梯度视角,把 REINFORCE 与信任域家族(TRPO、PPO)联系起来。
示意图共 1 张