问题
原版 REINFORCE 能工作,但它的方差大得可怕。蒙特卡洛回报 G_t 在不同回合之间能摆动一个数量级。把这种噪声乘上 \nabla \log \pi 再平均,得到的梯度估计器需要上千个回合,才能把策略挪动到 DQN 用少得多的更新就能到达的位置。
方差来自直接使用原始回报。如果你减去一个基线 b(s_t)——任何关于状态的函数,包括学到的价值——期望不变,方差却会下降。最好用的可处理基线是 \hat{V}(s_t)。于是乘在 \nabla \log \pi 前面的量就是优势:
一个动作好,是因为它产生了高于平均的回报;差,是因为低于平均。带学习到的评论家的 REINFORCE 就是 actor-critic。评论家给演员一位低方差的老师。2015 年之后的每一种深度策略方法都是这个套路(A2C、A3C、PPO、SAC、IMPALA)。
概念
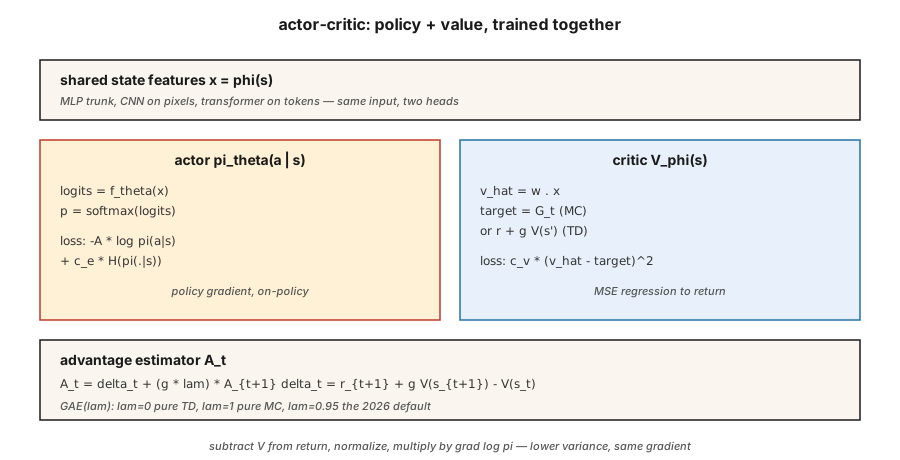
两个网络,一个合并损失:
- 演员(actor) \pi_\theta(a \mid s):策略。采样它来行动。用策略梯度训练。
- 评论家(critic) V_\phi(s):估计从状态出发的期望回报。通过最小化 (V_\phi(s) - \text{target})^2 训练。
优势。 两种标准形式:
- MC 优势: A_t = G_t - V_\phi(s_t)。无偏,方差较高。
- TD 优势: A_t = r_{t+1} + \gamma V_\phi(s_{t+1}) - V_\phi(s_t)。有偏(用了 V_\phi),方差低得多。也叫 TD 残差 \delta_t。
n 步优势。 在两者之间插值:
n = 1 是纯 TD。n = \infty 是 MC。多数实现里 Atari 用 n = 5,MuJoCo 上的 PPO 用 n = 2048。
广义优势估计(Generalized Advantage Estimation,GAE)。 Schulman 等人(2016)提出对所有 n 步优势做指数加权平均:
其中 \lambda \in [0, 1]。\lambda = 0 是 TD(低方差、高偏差)。\lambda = 1 是 MC(高方差、无偏)。\lambda = 0.95 是 2026 年的默认值——一直调,直到偏差/方差旋钮停在你想要的位置。
A2C:同步优势 actor-critic。 在 N 个并行环境里收集 T 步。计算每一步的优势。在合并后的 batch 上更新演员和评论家。重复。它是 A3C 更简单、更易扩展的兄弟。
A3C:异步优势 actor-critic。 Mnih 等人(2016)。拉起 N 个工作线程,每个跑一个环境。每个工作线程在自己的 rollout 上本地计算梯度,然后异步地应用到共享的参数服务器。不需要回放缓冲区——工作线程靠跑不同的轨迹来去相关。A3C 证明了可以在 CPU 上大规模训练。到了 2026 年,基于 GPU 的 A2C(批处理并行环境)占主导,因为 GPU 想要大 batch。
合并损失。
三项:策略梯度损失、价值回归、熵奖励。c_v ~ 0.5、c_e ~ 0.01 是经典的起点。
构建它
第 1 步:评论家
线性评论家 V_\phi(s) = w \cdot \text{features}(s),用 MSE 更新:
pythondef critic_update(w, x, target, lr):
v_hat = dot(w, x)
err = target - v_hat
for j in range(len(w)):
w[j] += lr * err * x[j]
return v_hat在表格型环境上,评论家几百个回合就能收敛。在 Atari 上,把线性评论家换成共享 CNN 主干加一个价值头。
第 2 步:n 步优势
给定长度为 T 的 rollout 和自举得到的最终 V(s_T):
pythondef compute_advantages(rewards, values, gamma=0.99, lam=0.95, last_value=0.0):
advantages = [0.0] * len(rewards)
gae = 0.0
for t in reversed(range(len(rewards))):
next_v = values[t + 1] if t + 1 < len(values) else last_value
delta = rewards[t] + gamma * next_v - values[t]
gae = delta + gamma * lam * gae
advantages[t] = gae
returns = [a + v for a, v in zip(advantages, values)]
return advantages, returnsreturns 是评论家的目标。advantages 是乘在 \nabla \log \pi 上的东西。
第 3 步:合并更新
pythonfor step_i, (x, a, _r, probs) in enumerate(traj):
adv = advantages[step_i]
target_v = returns[step_i]
# critic
critic_update(w, x, target_v, lr_v)
# actor
for i in range(N_ACTIONS):
grad_logpi = (1.0 if i == a else 0.0) - probs[i]
for j in range(N_FEAT):
theta[i][j] += lr_a * adv * grad_logpi * x[j]同策略,每次更新只用一个 rollout,演员和评论家用各自的学习率。
第 4 步:并行化(A3C vs A2C)
- A3C: 拉起 N 个线程。每个线程跑自己的环境、做自己的前向传播。定期把梯度更新推给共享的 master。master 上不加锁——竞态可以接受,它们只是增加噪声。
- A2C: 在单个进程里跑 N 个环境实例,把观测堆成
[N, obs_dim]的 batch,批量前向、批量反向。GPU 利用率更高、确定性强、更容易推理。这是 2026 年的默认做法。
我们的玩具代码为了清晰是单线程的;改写成批处理 A2C 只需要三行 numpy。
常见陷阱
- 演员梯度前评论家还有偏差。 如果评论家是随机的,它的基线就没有信息量,你等于在纯噪声上训练。先让评论家热身几百步再打开策略梯度,或者给演员用很慢的学习率。
- 优势归一化。 每个 batch 把优势归一化成零均值、单位标准差。以近乎零的成本换来训练的大幅稳定。
- 共享主干。 图像输入上,让演员和评论家共享特征提取器,头部分开。共享特征从两个损失里都白拿好处。
- 同策略契约。 A2C 的数据只复用一次更新。复用更多,梯度就有偏(PPO 加入的重要性采样校正正是为此)。
- 熵坍缩。 没有 c_e > 0,策略会在几百次更新内接近确定性,停止探索。
- 奖励尺度。 优势的幅度取决于奖励尺度。对奖励做归一化(例如除以滑动标准差),让不同任务的梯度幅度保持一致。
使用它
A2C/A3C 在 2026 年很少是最终选择,但它们是后续一切方法所精炼的架构:
| 方法 | 与 A2C 的关系 |
|---|---|
| PPO | A2C + 裁剪的重要性比率,支持多 epoch 更新 |
| IMPALA | A3C + V-trace 异策略校正 |
| SAC(Phase 9 · 07) | 带软价值评论家的异策略 A2C(下一课) |
| GRPO(Phase 9 · 12) | 去掉评论家的 A2C——组相对优势 |
| DPO | A2C 坍缩成偏好排序损失,无需采样 |
| AlphaStar / OpenAI Five | A2C + 联赛训练 + 模仿预训练 |
如果你在 2026 年的论文里看到 "advantage",就想到 actor-critic。
交付它
保存为 outputs/skill-actor-critic-trainer.md:
markdown---
name: actor-critic-trainer
description: Produce an A2C / A3C / GAE configuration for a given environment, with advantage estimation and loss weights specified.
version: 1.0.0
phase: 9
lesson: 7
tags: [rl, actor-critic, gae]
---
Given an environment and compute budget, output:
1. Parallelism. A2C (GPU batched) vs A3C (CPU async) and the number of workers.
2. Rollout length T. Steps per env per update.
3. Advantage estimator. n-step or GAE(λ); specify λ.
4. Loss weights. `c_v` (value), `c_e` (entropy), gradient clip.
5. Learning rates. Actor and critic (separate if using).
Refuse single-worker A2C on environments with horizon > 1000 (too on-policy, too slow). Refuse to ship without advantage normalization. Flag any run with `c_e = 0` and observed entropy < 0.1 as entropy-collapsed.练习
- 简单。 在 4×4 GridWorld 上用 MC 优势 (G_t - V(s_t)) 训练 actor-critic。与第 06 课里带滑动均值基线的 REINFORCE 对比样本效率。
- 中等。 换成 TD 残差优势 (r + \gamma V(s') - V(s))。测量优势 batch 的方差。它下降了多少?
- 困难。 实现 GAE(λ)。扫描 \lambda \in \lbrace 0, 0.5, 0.9, 0.95, 1.0 \rbrace。画出最终回报随样本效率的变化。这个任务的偏差/方差最佳点在哪里?
关键术语
| 术语 | 人们怎么说 | 它实际指什么 |
|---|---|---|
| Actor | "策略网络" | \pi_\theta(a \mid s),由策略梯度更新。 |
| Critic | "价值网络" | V_\phi(s),通过对回报 / TD 目标做 MSE 回归更新。 |
| Advantage | "比平均好多少" | A(s, a) = Q(s, a) - V(s) 或其估计量。是 \nabla \log \pi 的乘数。 |
| TD residual | "δ" | \delta_t = r + \gamma V(s') - V(s);单步优势估计。 |
| GAE | "插值旋钮" | n 步优势的指数加权和,由 \lambda 参数化。 |
| A2C | "同步 actor-critic" | 跨环境批处理;每个 rollout 一次梯度步。 |
| A3C | "异步 actor-critic" | 工作线程把梯度推给共享参数服务器。原始论文;2026 年已不太常见。 |
| Bootstrap | "在时界处用 V" | 截断 rollout,加上 \gamma^n V(s_{t+n}) 来闭合求和。 |
延伸阅读
- Mnih et al. (2016). Asynchronous Methods for Deep Reinforcement Learning — A3C,异步 actor-critic 的原始论文。
- Schulman et al. (2016). High-Dimensional Continuous Control Using Generalized Advantage Estimation — GAE。
- Sutton & Barto (2018). Ch. 13 — Actor-Critic Methods — 基础;当评论家是神经网络时,搭配第 9 章关于函数逼近的内容一起读。
- Espeholt et al. (2018). IMPALA — 可扩展的分布式 actor-critic,带 V-trace 异策略校正。
- OpenAI Baselines / Stable-Baselines3 — 值得一读的生产级 A2C/PPO 实现。
- Konda & Tsitsiklis (2000). Actor-Critic Algorithms — 双时间尺度 actor-critic 分解的基础收敛性结果。
示意图共 1 张