问题
A2C(第 07 课)是同策略的:梯度 \mathbb E_{\pi_\theta}[A \cdot \nabla \log \pi_\theta] 要求数据采样自当前的 \pi_\theta。做一次更新,\pi_\theta 就变了;你刚用过的数据现在成了异策略。再复用它,梯度就有偏。
Rollout 很贵。在 Atari 上,跨 8 个环境 × 128 步的一次 rollout 是 1024 条转移,外加十几秒的环境时间。只做一次梯度步就把它扔掉太浪费了。
信赖域策略优化(Trust Region Policy Optimization,TRPO,Schulman 2015)是第一个解法:约束每次更新,使新旧策略之间的 KL 散度保持在 \delta 以下。理论上干净,但每次更新都需要解一次共轭梯度。2026 年没人跑 TRPO。
PPO(Schulman 等人 2017)用简单的裁剪目标取代了硬性信赖域约束。多一行代码。每个 rollout 十个 epoch。不需要共轭梯度。理论保证够用。九年过去,它仍然是 MuJoCo 到 RLHF 一切场景的默认策略梯度算法。
概念
重要性比率。
这是新策略相对于收集数据时那个策略的似然比。r_t = 1 表示没有变化。r_t = 2 表示新策略采取 a_t 的可能性是旧策略的两倍。
裁剪替代目标。
两项:
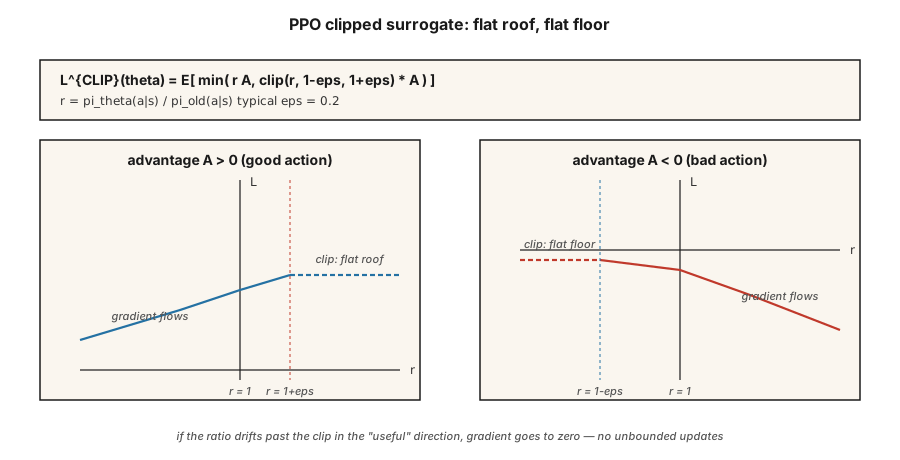
- 如果优势 A_t > 0,且比率试图增长到超过 1 + \epsilon,裁剪会把梯度压平——不要把一个好动作推到比旧概率高 +\epsilon 以上。
- 如果优势 A_t < 0,且比率试图增长到超过 1 - \epsilon(意味着相比裁剪后的缩减,我们会让一个坏动作更可能发生),裁剪会封住梯度——不要把一个坏动作压到 -\epsilon 以下。
min 处理另一个方向:如果比率已经朝有利方向移动,你仍然能得到梯度(会伤害你的那一侧不裁剪)。
典型的 \epsilon = 0.2。把目标画成 r_t 的函数:一条分段线性函数,在「好的一侧」有平顶,在「坏的一侧」有平底。
完整的 PPO 损失。
与 A2C 相同的 actor-critic 结构。三个系数,通常 c_v = 0.5、c_e = 0.01、\epsilon = 0.2。
训练循环。
- 在 N 个并行环境上各跑 T 步,收集 N \times T 条转移。
- 计算优势(GAE),把它们冻结为常数。
- 把 \pi_{\theta_{\text{old}}} 冻结为当前 \pi_\theta 的快照。
- 对 K 个 epoch,对每个
(s, a, A, V_target, log π_old(a|s))的小 batch:
- 计算 r_t(\theta) = \exp(\log \pi_\theta(a \mid s) - \log \pi_{\text{old}}(a \mid s))。
- 应用 L^{\text{CLIP}} + 价值损失 + 熵。
- 梯度步。
- 丢弃这个 rollout。回到第 1 步。
K = 10、小批量 64 是标准的超参数组合。PPO 很稳健:在 ±50% 以内,具体数字很少要紧。
KL 惩罚变体。 原论文提出了一个替代方案,使用自适应 KL 惩罚:L = L^{\text{PG}} - \beta \cdot \mathrm{KL}(\pi_\theta \Vert \pi_{\text{old}}),其中 \beta 根据观测到的 KL 调整。裁剪版本最终占据主导;KL 变体在 RLHF 里存活下来(在那里,对参考策略的 KL 本来就是你会一直想要的独立约束)。
构建它
第 1 步:在 rollout 时记录 log π_old(a | s)
pythonfor step in range(T):
probs = softmax(logits(theta, state_features(s)))
a = sample(probs, rng)
s_next, r, done = env.step(s, a)
buffer.append({
"s": s, "a": a, "r": r, "done": done,
"v_old": value(w, state_features(s)),
"log_pi_old": log(probs[a] + 1e-12),
})
s = s_next快照只取一次,在 rollout 时。它在更新 epoch 期间不会改变。
第 2 步:计算 GAE 优势(第 07 课)
与 A2C 相同。在整个 batch 上归一化。
第 3 步:裁剪替代目标更新
pythonfor _ in range(K_EPOCHS):
for mb in minibatches(buffer, size=64):
for rec in mb:
x = state_features(rec["s"])
probs = softmax(logits(theta, x))
logp = log(probs[rec["a"]] + 1e-12)
ratio = exp(logp - rec["log_pi_old"])
adv = rec["advantage"]
surrogate = min(
ratio * adv,
clamp(ratio, 1 - EPS, 1 + EPS) * adv,
)
# backprop -surrogate, add value loss, subtract entropy
grad_logpi = onehot(rec["a"]) - probs
if (adv > 0 and ratio >= 1 + EPS) or (adv < 0 and ratio <= 1 - EPS):
pg_grad = 0.0 # clipped
else:
pg_grad = ratio * adv
for i in range(N_ACTIONS):
for j in range(N_FEAT):
theta[i][j] += LR * pg_grad * grad_logpi[i] * x[j]「被裁剪 → 零梯度」这个模式是 PPO 的核心。如果新策略已经在有利方向上漂得太远,更新就停止。
第 4 步:价值与熵
给评论家目标加上标准 MSE,给演员加上熵奖励,与 A2C 相同。
第 5 步:诊断
每次更新要看三件事:
- 平均 KL \mathbb{E}[\log \pi_{\text{old}} - \log \pi_\theta]。应保持在
[0, 0.02]。如果冲过0.1,就减小K_EPOCHS或LR。 - 裁剪比例 —— 比率落在 [1-\epsilon, 1+\epsilon] 之外的样本占比。应在
~0.1-0.3。如果~0,裁剪从未触发 → 提高LR或K_EPOCHS。如果~0.5+,说明你在对 rollout 过拟合 → 把它们降下来。 - 解释方差 1 - \text{Var}(V_{\text{target}} - V_{\text{pred}}) / \text{Var}(V_{\text{target}})。评论家质量指标。随着评论家学习,应朝 1 攀升。
常见陷阱
- 裁剪系数调错。 \epsilon = 0.2 是事实上的标准。调到
0.1会让更新太胆小;0.3+会招来不稳定。 - epoch 太多。 K > 20 经常导致不稳定,因为策略离 \pi_{\text{old}} 漂得太远。给 epoch 设上限,尤其是大网络。
- 不做奖励归一化。 大的奖励尺度会侵蚀裁剪范围。在计算优势前归一化奖励(滑动标准差)。
- 忘了优势归一化。 每 batch 的零均值/单位标准差归一化是标准做法。跳过它会在多数基准上毁掉 PPO。
- 学习率没有衰减。 PPO 受益于学习率线性衰减到零。恒定学习率通常更差。
- 重要性比率算错。 为了数值稳定,始终用
exp(log_new - log_old),而不是new / old。 - 梯度符号搞反。 最大化替代目标 = 最小化 -L^{\text{CLIP}}。符号翻转是 PPO 最常见的 bug。
使用它
PPO 是 2026 年在多得惊人的领域里的默认强化学习算法:
| 用例 | PPO 变体 |
|---|---|
| MuJoCo / 机器人控制 | 高斯策略的 PPO,GAE(0.95) |
| Atari / 离散游戏 | 类别策略的 PPO,滚动 128 步 rollout |
| LLM 的 RLHF | 对参考模型加 KL 惩罚的 PPO,奖励在回复末尾由 RM 给出 |
| 大规模游戏 Agent | IMPALA + PPO(AlphaStar、OpenAI Five) |
| 推理 LLM | GRPO(第 12 课)——去掉评论家的 PPO 变体 |
| 仅偏好数据 | DPO —— PPO+KL 的闭式坍缩,无需在线采样 |
PPO 的损失形状——裁剪替代目标 + 价值 + 熵——是 DPO、GRPO 以及几乎所有 RLHF pipeline 的脚手架。
交付它
保存为 outputs/skill-ppo-trainer.md:
markdown---
name: ppo-trainer
description: Produce a PPO training config and a diagnostic plan for a given environment.
version: 1.0.0
phase: 9
lesson: 8
tags: [rl, ppo, policy-gradient]
---
Given an environment and training budget, output:
1. Rollout size. `N` envs × `T` steps.
2. Update schedule. `K` epochs, minibatch size, LR schedule.
3. Surrogate params. `ε` (clip), `c_v`, `c_e`, advantage normalization on.
4. Advantage. GAE(`λ`) with explicit `γ` and `λ`.
5. Diagnostics plan. KL, clip fraction, explained variance thresholds with alerts.
Refuse `K > 30` or `ε > 0.3` (unsafe trust region). Refuse any PPO run without advantage normalization or KL/clip monitoring. Flag clip fraction sustained above 0.4 as drift.练习
- 简单。 在 4×4 GridWorld 上跑 PPO,\epsilon=0.2, K=4。在环境步数相同的情况下,与 A2C(每个 rollout 一个 epoch)对比样本效率。
- 中等。 扫描 K \in \lbrace 1, 4, 10, 30 \rbrace。画出回报随环境步数的变化,并跟踪每次更新的平均 KL。在这个任务上,K 多大时 KL 会爆炸?
- 困难。 用自适应 KL 惩罚替换裁剪替代目标(\mathrm{KL} > 2 \cdot \text{target} 时 \beta 翻倍,\mathrm{KL} < \text{target}/2 时减半)。对比最终回报、稳定性和无裁剪程度。
关键术语
| 术语 | 人们怎么说 | 它实际指什么 |
|---|---|---|
| Importance ratio | "r_t(θ)" | \pi_\theta(a \mid s) / \pi_{\text{old}}(a \mid s);相对收集数据时策略的偏离程度。 |
| Clipped surrogate | "PPO 的主要技巧" | \min(r \cdot A, \mathop{\mathrm{clip}}(r, 1-\epsilon, 1+\epsilon) \cdot A);在有利一侧越过裁剪点后梯度压平。 |
| Trust region | "TRPO / PPO 的意图" | 限制每次更新的 KL,以保证单调改进。 |
| KL penalty | "软信赖域" | 替代版 PPO:L - \beta \cdot \mathrm{KL}(\pi_\theta \Vert \pi_{\text{old}})。自适应 \beta。 |
| Clip fraction | "裁剪触发的频率" | 诊断指标——应在 0.1-0.3;超出说明调参不当。 |
| Multi-epoch training | "数据复用" | 每个 rollout 跑 K 个 epoch;用方差代价换样本效率。 |
| On-policy-ish | "大体同策略" | PPO 名义上是同策略,但 K>1 个 epoch 会安全地使用略微异策略的数据。 |
| PPO-KL | "另一个 PPO" | KL 惩罚变体;用于 RLHF,那里对参考模型的 KL 本来就是约束。 |
延伸阅读
- Schulman et al. (2017). Proximal Policy Optimization Algorithms — 原论文。
- Schulman et al. (2015). Trust Region Policy Optimization — TRPO,PPO 的前身。
- Andrychowicz et al. (2021). What Matters In On-Policy RL? A Large-Scale Empirical Study — 对每个 PPO 超参数都做了消融。
- Ouyang et al. (2022). Training language models to follow instructions with human feedback — InstructGPT;RLHF 中用 PPO 的配方。
- OpenAI Spinning Up — PPO — 干净现代的讲解,配 PyTorch。
- CleanRL PPO implementation — 许多论文使用的单文件 PPO 参考实现。
- Hugging Face TRL — PPOTrainer — 语言模型上 PPO 的生产配方;与第 09 课(RLHF)对照阅读。
- Engstrom et al. (2020). Implementation Matters in Deep Policy Gradients — 那篇「37 项代码级优化」论文;哪些 PPO 技巧是承重的,哪些只是民间传说。
示意图共 1 张