问题
你有一段 10 秒、16 kHz 的音频,想要得到一个字符串:「turn on the kitchen lights」。挑战是结构性的:音频帧与字符并非一一对齐。「okay」这个词可能持续 200 ms,也可能持续 1200 ms。静音把话语隔开。有些音素比另一些长。输出 token 的数量事先未知。
三种建模方式解决了这个问题:
- CTC(Connectionist Temporal Classification,连接时序分类)。 输出每帧的 token 概率,其中包含一个特殊的空白(blank)。解码时合并重复并去掉空白。非自回归,速度快。wav2vec 2.0、MMS 使用它。
- RNN-T(Recurrent Neural Network Transducer,循环神经网络转录器)。 联合网络根据编码器帧和先前 token 预测下一个 token。可流式。Google 的设备端 ASR、NVIDIA Parakeet 使用它。
- 注意力编码器-解码器。 编码器把音频压缩为隐藏状态,解码器通过交叉注意力自回归生成 token。Whisper、SeamlessM4T 使用它。
2026 年,LibriSpeech test-clean 上的 SOTA WER 为 1.4%(Parakeet-TDT-1.1B,NVIDIA)和 1.58%(Whisper-Large-v3-turbo)。这些差距很小,但部署上的差异巨大。
概念
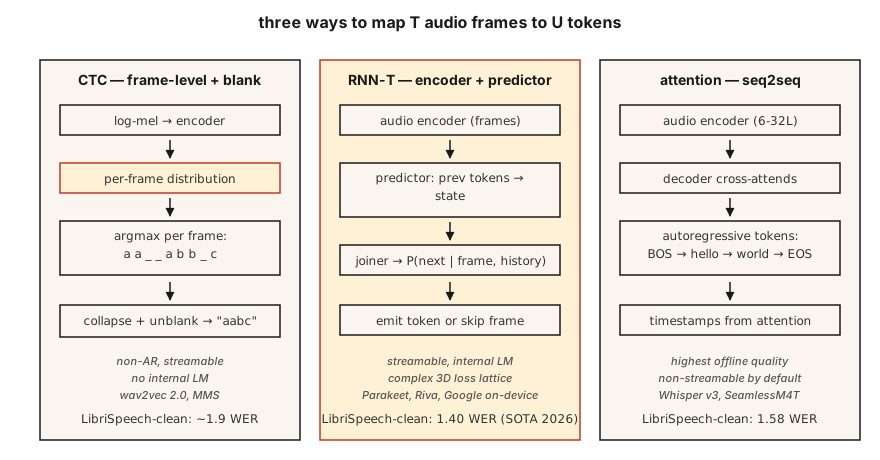
CTC 直觉。 让编码器输出 T 个帧级分布,覆盖 V+1 个 token(V 个字符 + 空白)。对于长度为 U < T 的目标字符串 y,任何能合并成 y 的帧对齐都计入。CTC 损失对所有这类对齐求和。推理:逐帧取 argmax,合并重复,去掉空白。
优点:非自回归、可流式、零前瞻。缺点:条件独立假设——每帧预测与其他帧无关,因此没有内部语言模型。可通过 beam search 或浅融合(shallow fusion)接入外部 LM 来弥补。
RNN-T 直觉。 增加一个预测器网络来嵌入 token 历史,以及一个联合器把预测器状态与编码器帧合成为覆盖 V+1 个 token 的联合分布(+1 是 null / 不输出)。它显式建模了 CTC 忽略的条件依赖。由于每一步只依赖过去的帧和过去的 token,因此可流式。
优点:可流式 + 内置 LM。缺点:训练更复杂、更耗内存(3D 损失格);RNN-T 损失核本身就是一整类库。
注意力编码器-解码器。 编码器(6–32 层 Transformer)处理 log-mel 帧。解码器(6–32 层 Transformer)通过交叉注意力关注编码器输出,自回归生成 token。没有对齐约束——注意力可以看音频中的任何位置。除非限制注意力,否则无法流式(分块的 Whisper-Streaming,2024)。
优点:离线 ASR 质量最高,用标准 seq2seq 工具即可轻松训练。缺点:自回归延迟与输出长度成正比;不经工程改造无法流式。
WER:那个唯一的数字
词错误率(Word Error Rate) = (S + D + I) / N,其中 S 是替换数,D 是删除数,I 是插入数,N 是参考词数。它等价于词级别的 Levenshtein 编辑距离。越低越好。WER 高于 20% 通常不可用;低于 5% 则对朗读语音达到人类水平。2026 年标准基准上的数字:
| 模型 | LibriSpeech test-clean | LibriSpeech test-other | 规模 |
|---|---|---|---|
| Parakeet-TDT-1.1B | 1.40% | 2.78% | 1.1B 参数 |
| Whisper-Large-v3-turbo | 1.58% | 3.03% | 809M |
| Canary-1B Flash | 1.48% | 2.87% | 1B |
| Seamless M4T v2 | 1.7% | 3.5% | 2.3B |
所有这些都基于编码器-解码器或 RNN-T。纯 CTC 系统(wav2vec 2.0)在 test-clean 上约为 1.8–2.1%。
构建它
第 1 步:贪心 CTC 解码
pythondef ctc_greedy(frame_logits, blank=0, vocab=None):
# frame_logits: list of per-frame probability vectors
preds = [max(range(len(p)), key=lambda i: p[i]) for p in frame_logits]
out = []
prev = -1
for p in preds:
if p != prev and p != blank:
out.append(p)
prev = p
return "".join(vocab[i] for i in out) if vocab else out两条规则:合并连续重复,丢弃空白。例如:a a _ _ a b b _ c → a a b c。
第 2 步:beam search CTC
pythondef ctc_beam(frame_logits, beam=8, blank=0):
import math
beams = [([], 0.0)] # (tokens, log_prob)
for p in frame_logits:
log_p = [math.log(max(pi, 1e-10)) for pi in p]
candidates = []
for seq, lp in beams:
for t, lpt in enumerate(log_p):
new = seq[:] if t == blank else (seq + [t] if not seq or seq[-1] != t else seq)
candidates.append((new, lp + lpt))
candidates.sort(key=lambda x: -x[1])
beams = candidates[:beam]
return beams[0][0]生产环境使用带 LM 融合的前缀树 beam search;这里只是概念骨架。
第 3 步:WER
pythondef wer(ref, hyp):
r, h = ref.split(), hyp.split()
dp = [[0] * (len(h) + 1) for _ in range(len(r) + 1)]
for i in range(len(r) + 1):
dp[i][0] = i
for j in range(len(h) + 1):
dp[0][j] = j
for i in range(1, len(r) + 1):
for j in range(1, len(h) + 1):
cost = 0 if r[i - 1] == h[j - 1] else 1
dp[i][j] = min(
dp[i - 1][j] + 1,
dp[i][j - 1] + 1,
dp[i - 1][j - 1] + cost,
)
return dp[len(r)][len(h)] / max(1, len(r))第 4 步:用 Whisper 做推理
pythonimport whisper
model = whisper.load_model("large-v3-turbo")
result = model.transcribe("clip.wav")
print(result["text"])一行代码即可得到 2026 年最强的通用 ASR。在 24 GB GPU 上以约 20 倍实时速度运行。
第 5 步:用 Parakeet 或 wav2vec 2.0 做流式
pythonfrom transformers import pipeline
asr = pipeline("automatic-speech-recognition", model="nvidia/parakeet-tdt-1.1b")
for chunk in streaming_audio():
print(asr(chunk, return_timestamps=True))流式 ASR 需要分块的编码器注意力与跨块保留状态;请使用支持这些的库(Parakeet 用 NeMo,transformers pipeline 用 chunk_length_s)。
使用它
2026 年的技术栈:
| 情形 | 选择 |
|---|---|
| 英语、离线、最高质量 | Whisper-large-v3-turbo |
| 多语言、鲁棒 | SeamlessM4T v2 |
| 流式、低延迟 | Parakeet-TDT-1.1B 或 Riva |
| 边缘、移动端、延迟 <500 ms | 量化版 Whisper-Tiny 或 Moonshine(2024) |
| 长音频 | 基于 VAD 分块的 Whisper(WhisperX) |
| 特定领域(医疗、法律) | 微调 wav2vec 2.0 + 领域 LM 融合 |
2026 年仍在交付的坑
- 没有 VAD。 对静音运行 Whisper 会产生幻觉(「Thanks for watching!」)。始终用 VAD 把关。
- 字符级 vs 词级 vs 子词级 WER。 报告时要在归一化(转小写、去标点)之后计算词级 WER。
- 语言识别漂移。 Whisper 的自动 LID 会把嘈杂音频错误路由到日语或威尔士语;已知语言时强制
language="en"。 - 长音频不分块。 Whisper 的窗口是 30 秒。超过时使用
chunk_length_s=30, stride=5。
交付它
保存为 outputs/skill-asr-picker.md。为给定的部署目标选择模型、解码策略、分块方式与 LM 融合。
练习
- 简单。 运行
code/main.py。它对一个手工构造的 CTC 输出做贪心解码,并计算相对参考的 WER。 - 中等。 正确实现第 2 步的前缀树 beam search(考虑空白合并规则)。在一个 10 样本的合成数据集上与贪心解码比较。
- 困难。 在 LibriSpeech test-clean 上使用
whisper-large-v3-turbo。计算前 100 条话语的 WER,与已发表的数字比较。
关键术语
| 术语 | 常见说法 | 实际含义 |
|---|---|---|
| CTC | 空白 token 损失 | 对所有帧到 token 对齐求边缘分布;非自回归。 |
| RNN-T | 流式损失 | CTC + 下一 token 预测器;能处理词序。 |
| 注意力编码器-解码器 | Whisper 风格 | 编码器 + 交叉注意力解码器;离线质量最佳。 |
| WER | 你报告的那个数字 | 词级的 (S+D+I)/N。 |
| 空白(blank) | 空 | CTC 中的特殊 token,表示「本帧不输出」。 |
| LM 融合 | 外部语言模型 | 在 beam search 中加上加权 LM 对数概率。 |
| VAD | 静音门限 | 语音活动检测器;裁剪非语音段。 |
延伸阅读
- Graves et al. (2006). Connectionist Temporal Classification —— CTC 论文。
- Graves (2012). Sequence Transduction with RNNs —— RNN-T 论文。
- Radford et al. / OpenAI (2022). Whisper: Robust Speech Recognition via Large-Scale Weak Supervision —— 2022 年权威论文;2024 年扩展到 v3-turbo。
- NVIDIA NeMo — Parakeet-TDT card —— 2026 年 Open ASR Leaderboard 榜首。
- Hugging Face — Open ASR Leaderboard —— 覆盖 25+ 模型的实时基准。
示意图共 1 张