2026 年的音频语言模型能对语音 + 环境声 + 音乐进行推理。Qwen2.5-Omni-7B 在 MMAU-Pro 上与 GPT-4o Audio 持平。Audio Flamingo Next 在 LongAudioBench 上击败 Gemini 2.5 Pro。开源与闭源的差距基本已经闭合——唯独多音频任务例外,在那里所有人都接近随机。
问题
你有 5 秒音频:狗叫,有人喊 "stop!",然后安静下来。有用的问题横跨多个维度:
- 转写。 "What was said?"——ASR 的领域。
- 语义推理。 "Is the person in danger?"——需要联合理解狗叫 + 喊叫 + 沉默。
- 音乐推理。 "What instruments play the melody?"
- 长音频检索。 "Where in this 90-minute lecture did the instructor explain gradient descent?"
用一个提示就能回答所有这些问题的单一模型,就是音频语言模型(audio-language model,LALM / ALM)。它与纯 ASR 不同:LALM 产出自由形式的自然语言回答,而不仅是转写。
概念
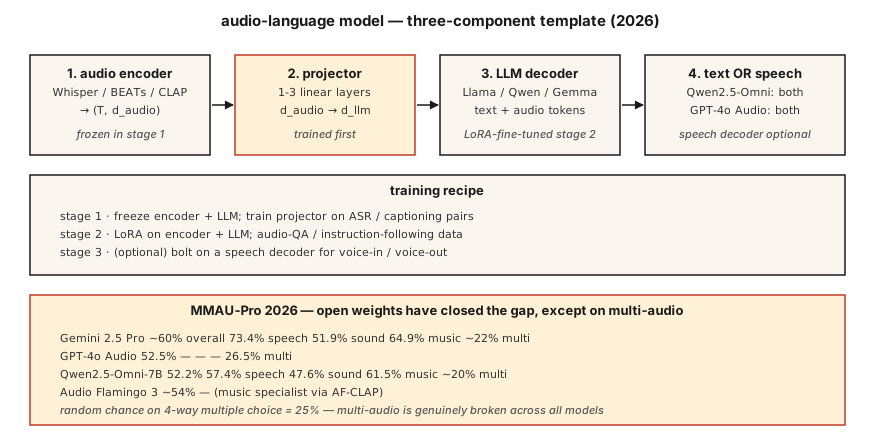
三组件模板
2026 年的每个 LALM 都有相同的骨架:
- 音频编码器。 Whisper 编码器 · BEATs · CLAP · WavLM · 或各模型自定义的编码器。
- 投影器。 线性层或 MLP,把音频编码器特征桥接到 LLM 的 token 嵌入空间。
- LLM。 基于 Llama / Qwen / Gemma 的解码器。接收交错的文本 + 音频 token;生成文本。
训练:
- 阶段 1。 冻结编码器 + LLM;仅在 ASR / 描述数据上训练投影器。
- 阶段 2。 在指令跟随类音频任务(QA、推理、音乐理解)上做全量 / LoRA 微调。
- 阶段 3(可选)。 语音输入 / 语音输出会增加一个语音解码器。Qwen2.5-Omni 和 AF3-Chat 就这样做。
2026 年模型地图
| 模型 | 主干 | 音频编码器 | 输出模态 | 获取方式 |
|---|---|---|---|---|
| Qwen2.5-Omni-7B | Qwen2.5-7B | 自定义 + Whisper | 文本 + 语音 | Apache-2.0 |
| Qwen3-Omni | Qwen3 | 自定义 | 文本 + 语音 | Apache-2.0 |
| Audio Flamingo 3 | Qwen2 | AF-CLAP | 文本 | NVIDIA 非商业 |
| Audio Flamingo Next | Qwen2 | AF-CLAP v2 | 文本 | NVIDIA 非商业 |
| SALMONN | Vicuna | Whisper + BEATs | 文本 | Apache-2.0 |
| LTU / LTU-AS | Llama | CAV-MAE | 文本 | Apache-2.0 |
| GAMA | Llama | AST + Q-Former | 文本 | Apache-2.0 |
| Gemini 2.5 Flash/Pro(闭源) | Gemini | 专有 | 文本 + 语音 | API |
| GPT-4o Audio(闭源) | GPT-4o | 专有 | 文本 + 语音 | API |
基准现实检验(2026)
MMAU-Pro。 1800 个 QA 对,覆盖语音 / 声音 / 音乐 / 混合。包含多音频子集。
| 模型 | 总体 | 语音 | 声音 | 音乐 | 多音频 |
|---|---|---|---|---|---|
| Gemini 2.5 Pro | ~60% | 73.4% | 51.9% | 64.9% | ~22% |
| Gemini 2.5 Flash | ~57% | 73.4% | 50.5% | 64.9% | 21.2% |
| GPT-4o Audio | 52.5% | — | — | — | 26.5% |
| Qwen2.5-Omni-7B | 52.2% | 57.4% | 47.6% | 61.5% | ~20% |
| Audio Flamingo 3 | ~54% | — | — | — | — |
| Audio Flamingo Next | LongAudioBench 上 SOTA | — | — | — | — |
多音频一列对所有模型都很打脸。 4 选项选择题的随机概率 = 25%;大多数模型的得分就在这附近。LALM 在比较两段音频上仍然吃力。
2026 年 LALM 的用武之地
- 呼叫中心录音的合规审计。 "Did the agent mention the required disclosure?"
- 无障碍。 向失聪用户描述声音事件(不只是转写)。
- 内容审核。 检测暴力语言 + 威胁语气 + 背景上下文。
- 播客 / 会议章节划分。 语义摘要,而不只是说话人轮次。
- 音乐曲库分析。 "Find all tracks with a B-section key change."
它们(还)不适合的地方
- 细粒度乐理(低于和弦级别)。
- 长对话中带说话人归属的推理(超过 10 分钟就退化)。
- 多音频比较(22-26% 仅略高于随机)。
- 实时流式推理(大多数是离线批处理推理)。
构建它
第 1 步:查询 Qwen2.5-Omni
pythonfrom transformers import AutoModelForCausalLM, AutoProcessor
processor = AutoProcessor.from_pretrained("Qwen/Qwen2.5-Omni-7B")
model = AutoModelForCausalLM.from_pretrained("Qwen/Qwen2.5-Omni-7B", torch_dtype="auto")
audio, sr = load_wav("clip.wav", sr=16000)
messages = [{
"role": "user",
"content": [
{"type": "audio", "audio": audio},
{"type": "text", "text": "What sounds do you hear, and what's happening?"},
],
}]
inputs = processor.apply_chat_template(messages, tokenize=True, return_tensors="pt")
output = model.generate(**inputs, max_new_tokens=200)
print(processor.decode(output[0], skip_special_tokens=True))第 2 步:投影器模式
pythonimport torch.nn as nn
class AudioProjector(nn.Module):
def __init__(self, audio_dim=1280, llm_dim=4096):
super().__init__()
self.down = nn.Linear(audio_dim, llm_dim)
self.act = nn.GELU()
self.up = nn.Linear(llm_dim, llm_dim)
def forward(self, audio_features):
return self.up(self.act(self.down(audio_features)))就这样。投影器通常只有 1-3 个线性层。在 ASR 对(音频 → 转写)上训练它,就是阶段 1 的预训练任务。
第 3 步:跑 MMAU / LongAudioBench 基准
pythonfrom datasets import load_dataset
mmau = load_dataset("gamma-lab-umd/MMAU-Pro", split="test")
mcq = mmau.filter(lambda item: len(item["choices"] or []) > 1)
correct = 0
for item in mcq:
answer = call_model(item["audio_path"], item["question"], item["choices"])
if answer == item["answer"]:
correct += 1
print(f"Accuracy: {correct / len(mcq):.3f}")audio_path 指向数据集仓库里的 data.zip(约 47 GB),评分前需先下载并解压。这个精确匹配循环只是健全性检查,不是基准评分器,所以它的数字不能与已发表的 MMAU-Pro 结果相比。官方评估器用嵌入相似度(NV-Embed-v2)匹配选择题答案,用 LLM 裁判给开放式答案打分,并用正则规则检查指令跟随类答案:把预测写入 model_output 列,然后运行 MMAU-Pro 仓库 里的 evaluate_mmau_pro_comprehensive.py。按每个 category(speech、sound、music、multi 等)分别报告。聚合数字会掩盖模型失败的地方。
使用它
| 任务 | 2026 年选择 |
|---|---|
| 自由形式音频 QA(开源) | Qwen2.5-Omni-7B |
| 长音频最佳开源 | Audio Flamingo Next |
| 最佳闭源 | Gemini 2.5 Pro |
| 语音输入 / 语音输出 Agent | Qwen2.5-Omni 或 GPT-4o Audio |
| 音乐推理 | Audio Flamingo 3 或 2(音乐专用的 AF-CLAP) |
| 呼叫中心审计 | 通过 API 使用 Gemini 2.5 Pro,并在你的政策文档上做 RAG |
常见陷阱
- 过度信任多音频。 如果你的任务需要「哪段音频有 X」,随机水平的性能是真实存在的。
- 长音频退化。 超过 10 分钟,大多数模型的说话人归属就会失效。先做说话人分离(diarization,第 6 课),再摘要。
- 静音上的幻觉。 使用 Whisper 编码器的 LALM 会继承 Whisper 式的问题。用 VAD 门控。
- 基准挑选。 厂商博客突出的是最好情况下的类别。自己跑 MMAU-Pro 的多音频子集。
交付它
保存为 outputs/skill-alm-picker.md。为给定的音频理解任务选择 LALM + 基准子集 + 输出模态(文本还是语音)。
练习
- 简单。 运行
code/main.py,查看一个玩具投影器模式,以及(音频嵌入、文本 token)→ 输出 token 的模拟 LALM 路由。 - 中等。 在 100 条 MMAU-Pro 语音题上给 Qwen2.5-Omni-7B 打分。与论文报告的数字比较。
- 困难。 构建一个最小的音频描述基线:BEATs 编码器 + 2 层投影器 + 冻结的 Llama-3.2-1B。只在 AudioCaps 上微调投影器。在 Clotho-AQA 上与 SALMONN 比较。
关键术语
| 术语 | 人们怎么说 | 实际含义 |
|---|---|---|
| LALM | 音频版 ChatGPT | 音频编码器 + 投影器 + LLM 解码器。 |
| 投影器(Projector) | 适配器 | 把音频特征映射进 LLM 嵌入空间的小型 MLP。 |
| MMAU | 那个基准 | 覆盖语音、声音、音乐的一万对音频 QA。 |
| MMAU-Pro | 更难的 MMAU | 1800 个多音频 / 重推理问题。 |
| LongAudioBench | 长格式评估 | 带语义查询的多分钟音频。 |
| 语音输入 / 语音输出 | 原生语音 | 模型直接摄入语音并输出语音,不经过文本中转。 |
延伸阅读
- Chu et al. (2024). Qwen2-Audio —— 参考架构。
- Alibaba (2025). Qwen2.5-Omni —— 语音输入、语音输出。
- NVIDIA (2025). Audio Flamingo 3 —— 开源长音频领跑者。
- NVIDIA (2026). Audio Flamingo Next —— LongAudioBench SOTA。
- Tang et al. (2023). SALMONN —— 双编码器先驱。
- MMAU-Pro leaderboard —— 2026 年实时排名。
示意图共 1 张