问题
Whisper 由 OpenAI 于 2022 年 9 月发布,是第一个以商品化形态交付的 ASR 模型:粘贴音频,得到文本,支持 99 种语言,对噪声鲁棒,能在笔记本上运行。到 2024 年,OpenAI 已发布 Large-v3 与 Turbo 变体;到 2026 年,Whisper 已成为从播客转写到语音助手再到 YouTube 字幕的默认基线。
但 Whisper 不是一个可以永远当作黑盒的 pipeline。域偏移会杀死它——技术术语、说话人口音、专有名词、短音频、静音。你需要知道:
- 它内部究竟是什么。
- 如何正确地喂给它分块、流式或长音频。
- 何时微调,以及如何微调。
概念
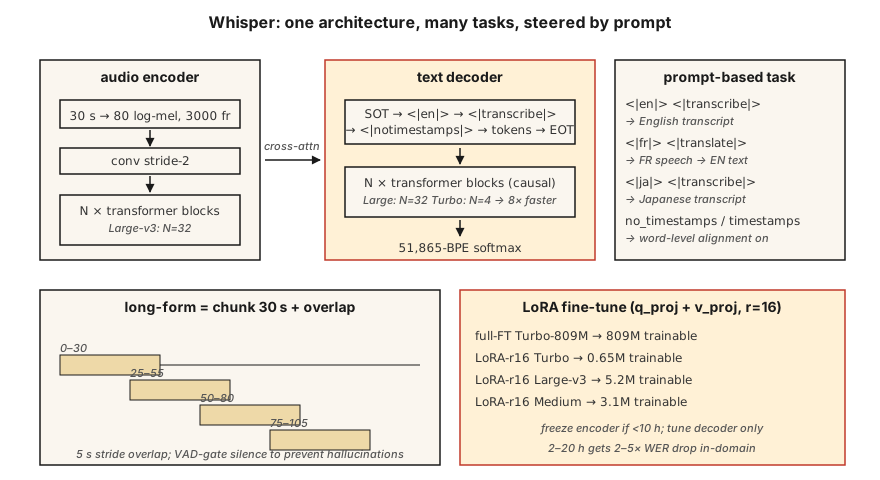
架构。 标准 Transformer 编码器-解码器。
- 输入:30 秒 log-mel 频谱图,80 个梅尔,10 ms 帧移 → 3000 帧。更短的音频补零,更长的音频分块。
- 编码器:卷积降采样(步长 2)+
N个 Transformer 块。Large-v3 为 32 层、1280 维、20 个注意力头。 - 解码器:
N个 Transformer 块,带因果自注意力 + 对编码器输出的交叉注意力。尺寸与编码器相同。 - 输出:基于 51,865 个 token 词表的 BPE token。
Large-v3 有 15.5 亿参数。Turbo 解码器从 32 层减为 4 层,延迟降低 8 倍,WER 只上升不到 1%。
提示格式。 Whisper 是一个通过解码器提示中的特殊 token 来引导的多任务模型:
<|startoftranscript|><|en|><|transcribe|><|notimestamps|> Hello world.<|endoftext|><|en|>—— 语言标签;决定翻译还是转写行为。<|transcribe|>或<|translate|>—— 逐字转写任意语言输入,或翻译成英语输出。<|notimestamps|>—— 跳过词级时间戳(更快)。
提示正是让一个模型完成多种任务的原因。把 <|en|> 换成 <|fr|>,它就转写法语。
30 秒窗口。 一切都固定在 30 秒。更长的音频需要分块;更短的音频需要填充。窗口不是原生流式的——这就是 WhisperX、Whisper-Streaming 和 faster-whisper 存在的原因。
Log-mel 归一化。 (log_mel - mean) / std,其中统计量来自 Whisper 自己的训练语料。你必须使用 Whisper 的预处理(whisper.audio.log_mel_spectrogram),而不是 librosa.feature.melspectrogram。
2026 年的变体
| 变体 | 参数 | 延迟(A100) | WER(LibriSpeech-clean) |
|---|---|---|---|
| Tiny | 39M | 1× 实时 | 5.4% |
| Base | 74M | 1× | 4.1% |
| Small | 244M | 1× | 3.0% |
| Medium | 769M | 1× | 2.7% |
| Large-v3 | 1.55B | 2× | 1.8% |
| Large-v3-turbo | 809M | 8× | 1.58% |
| Whisper-Streaming(2024) | 1.55B | 流式 | 2.0% |
微调
2026 年的标准流程:
- 收集 10–100 小时目标领域音频,并配对齐转写。
- 运行
transformers.Seq2SeqTrainer,配合generate_with_loss回调。 - 参数高效方案:在注意力层的
q_proj、k_proj、v_proj上做 LoRA,可将 GPU 显存减少 4 倍,WER 代价小于 0.3。 - 如果数据少于 10 小时,冻结编码器,只调解码器。
- 使用 Whisper 自己的 tokenizer 和提示格式;绝不要更换 tokenizer。
社区结果:在 20 小时医疗口述数据上微调 Medium,医疗词汇上的 WER 从 12% 降到 4.5%。在 4 小时冰岛语数据上微调 Turbo,WER 从 18% 降到 6%。
构建它
第 1 步:开箱即用运行 Whisper
pythonimport whisper
model = whisper.load_model("large-v3-turbo")
result = model.transcribe(
"clip.wav",
language="en",
task="transcribe",
temperature=0.0,
condition_on_previous_text=False, # prevents runaway repetition
)
print(result["text"])
for seg in result["segments"]:
print(f"[{seg['start']:.2f}–{seg['end']:.2f}] {seg['text']}")你应始终覆盖的关键默认值:temperature=0.0(采样默认按 0.0 → 0.2 → 0.4 … 的兜底链)、condition_on_previous_text=False(防止级联幻觉问题)、no_speech_threshold=0.6(静音检测)。
第 2 步:分块处理长音频
python# whisperx is the 2026 reference for long-form with word-level timestamps
import whisperx
model = whisperx.load_model("large-v3-turbo", device="cuda", compute_type="float16")
segments = model.transcribe("1hour.mp3", batch_size=16, chunk_size=30)WhisperX 增加了 (1) Silero VAD 把关,(2) 通过 wav2vec 2.0 做词级对齐,(3) 通过 pyannote.audio 做说话人分离。2026 年生产转写的主力工具。
第 3 步:用 LoRA 微调
pythonfrom transformers import WhisperForConditionalGeneration, WhisperProcessor
from peft import LoraConfig, get_peft_model
model = WhisperForConditionalGeneration.from_pretrained("openai/whisper-large-v3-turbo")
lora = LoraConfig(
r=16, lora_alpha=32, target_modules=["q_proj", "v_proj"],
lora_dropout=0.1, bias="none", task_type="SEQ_2_SEQ_LM",
)
model = get_peft_model(model, lora)
# model.print_trainable_parameters() -> ~3M trainable / 809M total之后走标准 Trainer 循环。每 1000 步保存 checkpoint。在留出集上用 WER 评估。
第 4 步:检查每一层学到了什么
python# Grab cross-attention weights during decode to see what the decoder attends to.
with torch.inference_mode():
out = model.generate(
input_features=features,
return_dict_in_generate=True,
output_attentions=True,
)
# out.cross_attentions: layer × head × step × src_len用热力图可视化——你会看到解码器步骤扫过编码器帧时形成的对角对齐。那条对角线就是 Whisper 对词级时间戳的理解。
使用它
2026 年的技术栈:
| 情形 | 选择 |
|---|---|
| 通用英语、离线 | 通过 whisperx 使用 Large-v3-turbo |
| 移动端 / 边缘 | 量化版 Whisper-Tiny(int8)或 Moonshine |
| 多语言长音频 | 通过 whisperx 使用 Large-v3 + 说话人分离 |
| 低资源语言 | 用 LoRA 微调 Medium 或 Turbo |
| 流式(2 秒延迟) | Whisper-Streaming 或 Parakeet-TDT |
| 词级时间戳 | WhisperX(通过 wav2vec 2.0 强制对齐) |
faster-whisper(CTranslate2 后端)是 2026 年最快的 CPU+GPU 推理运行时——比原版快 4 倍,输出完全一致。
2026 年仍在交付的坑
- 静音上的幻觉文本。 在字幕上训练的 Whisper 会输出「Thanks for watching!」「Subscribe!」和歌词。调用前始终用 VAD 把关。
condition_on_previous_text级联。 一次幻觉会污染后续窗口。除非你需要在分块之间保持流畅,否则设为False。- 短音频填充。 2 秒音频填充到 30 秒,可能在尾部静音中产生幻觉。使用
pad=False或用 VAD 把关。 - 错误的梅尔统计量。 使用 librosa 的梅尔而不是 Whisper 的,会产生近乎随机的输出。要用
whisper.audio.log_mel_spectrogram。
交付它
保存为 outputs/skill-whisper-tuner.md。为给定领域设计一个 Whisper 微调或推理 pipeline。
练习
- 简单。 运行
code/main.py。它对一个 Whisper 风格的提示做 tokenize,计算解码后的形状预算,并打印 10 分钟音频的分块计划。 - 中等。 安装
faster-whisper,转写一段 10 分钟播客,与人工转写比较 WER。尝试language="auto"与强制language="en"。 - 困难。 使用 HF
datasets,选一种 Whisper 表现不佳的语言(例如乌尔都语),用 LoRA 在 2 小时数据上微调 Medium 两个 epoch,报告 WER 差值。
关键术语
| 术语 | 常见说法 | 实际含义 |
|---|---|---|
| 30 秒窗口 | Whisper 的限制 | 硬性输入上限;更长的音频要分块。 |
| SOT | Start-of-transcript | <|startoftranscript|> 启动解码器提示。 |
| 时间戳 token | 时间对齐 | 每 0.02 秒的偏移是 51k 词表中的一个特殊 token。 |
| Turbo | 快速变体 | 4 层解码器,快 8 倍,WER 回退 <1%。 |
| WhisperX | 长音频封装 | VAD + Whisper + wav2vec 对齐 + 说话人分离。 |
| LoRA 微调 | 高效调优 | 给注意力加低秩适配器;只训练约 0.3% 的参数。 |
| 幻觉 | 静默失败 | Whisper 从噪声/静音中生成了流畅的英语。 |
延伸阅读
- Radford et al. (2022). Whisper paper —— 原始架构与训练配方。
- OpenAI (2024). Whisper Large-v3-turbo release —— 4 层解码器,8 倍加速。
- Bain et al. (2023). WhisperX —— 长音频、词级对齐、说话人分离。
- Systran — faster-whisper repo —— CTranslate2 后端,快 4 倍。
- HuggingFace — Whisper fine-tune tutorial —— 标准 LoRA / 全量微调教程。
示意图共 1 张