问题
你想要一个感觉「活着」的语音助手。人类对话轮替的延迟约为 230 ms(从静音到回应)。超过 500 ms 就显得机械;超过 1500 ms 就像坏了。2026 年一个完整听 → 理解 → 回应 → 说循环的预算为:
| 阶段 | 预算 |
|---|---|
| 麦克风 → 缓冲区 | 20 ms |
| VAD | 10 ms |
| ASR(流式) | 150 ms |
| LLM(首 token) | 100 ms |
| TTS(首块) | 100 ms |
| 渲染 → 扬声器 | 20 ms |
| 总计 | ~400 ms |
Moshi(Kyutai,2024)实现了 200 ms 的全双工。GPT-4o-realtime(2024)约为 320 ms。2022 年的级联 pipeline 交付时是 2500 ms。这 10 倍的提升来自三项技术:(1) 全链路流式,(2) 带部分结果的异步 pipeline,(3) 可中断生成。
概念
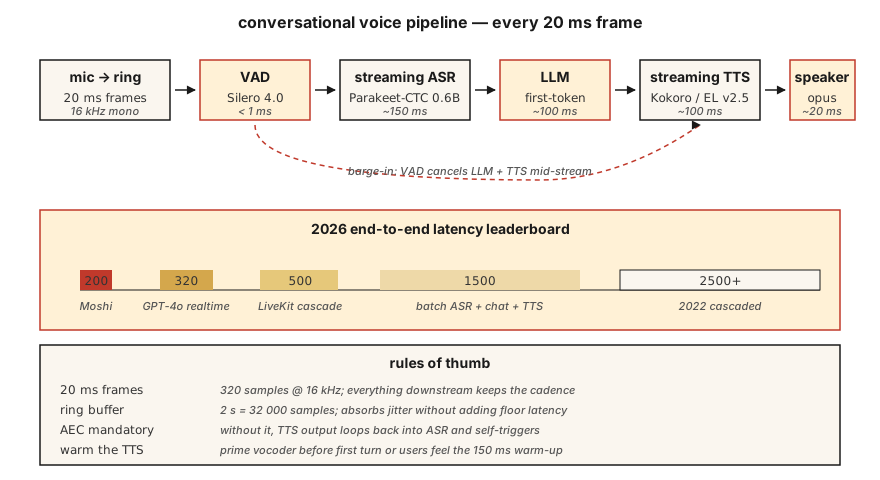
帧 / 块 / 窗口。 实时音频以固定大小的块流动。常见选择:20 ms(16 kHz 下 320 个采样点)。下游所有环节都必须跟上这个节奏。
环形缓冲区。 固定大小的循环缓冲区。生产者线程写入新帧,消费者线程读取。避免热路径上的内存分配。大小 ≈ 最大延迟 × 采样率;16 kHz 下的 2 秒环形缓冲区 = 32,000 个采样点。
VAD(语音活动检测)。 没人说话时关断下游工作。Silero VAD 4.0(2024)在 CPU 上每 30 ms 帧运行不到 1 ms。webrtcvad 是更老的替代方案。
流式 ASR。 音频到达时逐步输出部分转写的模型。流式模式下的 Parakeet-CTC-0.6B(NeMo,2024)在 320 ms 延迟下达到 2–5% WER。Whisper-Streaming(Macháček 等,2023)把 Whisper 分块,以约 2 秒延迟实现近流式。
中断。 当用户打断说话中的助手时,你必须 (a) 检测到 barge-in,(b) 停止 TTS,(c) 丢弃剩余的 LLM 输出。全部要在 100 ms 内完成,否则用户会觉得助手「聋了」。
WebRTC Opus 传输。 20 ms 帧,48 kHz,自适应码率 8–128 kbps。浏览器和移动端的事实标准。LiveKit、Daily.co、Pion 是 2026 年构建语音应用的技术栈。
抖动缓冲区。 网络包会乱序或延迟到达。抖动缓冲区负责重排和平滑;太小 → 可听见的间隙,太大 → 延迟。典型值 60–80 ms。
常见坑点
- 线程争用。 Python 的 GIL + 重模型会把音频线程饿死。使用 C 回调风格的音频库(sounddevice、PortAudio),让 Python 远离热路径。
- 采样率转换延迟。 在 pipeline 内重采样会增加 5–20 ms。要么提前重采样,要么用零延迟重采样器(PolyPhase、
soxr_hq)。 - TTS 预热。 即使像 Kokoro 这样快的 TTS,首次请求也有 100–200 ms 的预热。缓存模型,并在第一轮真实交互前用一次空跑预热。
- 回声消除。 没有 AEC,TTS 输出会重新进入麦克风,ASR 会转写机器人自己的声音。WebRTC AEC3 是开源默认选择。
构建它
第 1 步:环形缓冲区
pythonimport collections
class RingBuffer:
def __init__(self, capacity):
self.buf = collections.deque(maxlen=capacity)
def write(self, frame):
self.buf.extend(frame)
def read(self, n):
return [self.buf.popleft() for _ in range(min(n, len(self.buf)))]
def level(self):
return len(self.buf)容量决定最大缓冲延迟。16 kHz 下 32,000 个采样点 = 2 秒。
第 2 步:VAD 门控
pythondef simple_energy_vad(frame, threshold=0.01):
return sum(x * x for x in frame) / len(frame) > threshold ** 2生产环境中替换为 Silero VAD:
pythonimport torch
vad, _ = torch.hub.load("snakers4/silero-vad", "silero_vad")
is_speech = vad(torch.tensor(frame), 16000).item() > 0.5第 3 步:流式 ASR
python# Parakeet-CTC-0.6B streaming via NeMo
from nemo.collections.asr.models import EncDecCTCModelBPE
asr = EncDecCTCModelBPE.from_pretrained("nvidia/parakeet-ctc-0.6b")
# chunk_ms=320 ms, look_ahead_ms=80 ms
for chunk in audio_stream():
partial_text = asr.transcribe_streaming(chunk)
print(partial_text, end="\r")第 4 步:中断处理器
pythonclass Dialog:
def __init__(self):
self.tts_task = None
def on_user_speech(self, frame):
if self.tts_task and not self.tts_task.done():
self.tts_task.cancel() # barge-in
# then feed to streaming ASR
def on_final_user_utterance(self, text):
self.tts_task = asyncio.create_task(self.reply(text))
async def reply(self, text):
async for tts_chunk in llm_then_tts(text):
speaker.write(tts_chunk)关键在于异步 I/O 和可取消的 TTS 流式。在音频轨上调用 WebRTC 的 peerconnection.stop() 是标准做法。
使用它
2026 年的技术栈:
| 层 | 选择 |
|---|---|
| 传输 | LiveKit(WebRTC)或 Pion(Go) |
| VAD | Silero VAD 4.0 |
| 流式 ASR | Parakeet-CTC-0.6B 或 Whisper-Streaming |
| LLM 首 token | Groq、Cerebras、vLLM-streaming |
| 流式 TTS | Kokoro 或 ElevenLabs Turbo v2.5 |
| 回声消除 | WebRTC AEC3 |
| 端到端原生 | OpenAI Realtime API 或 Moshi |
常见陷阱
- 为了保险缓冲 500 ms。 缓冲区就是你的延迟下限。缩小它。
- 不设置线程优先级。 音频回调跑在比 UI 优先级更低的线程上 = 负载下出现爆音。
- TTS 块太小。 低于 200 ms 的块会让声码器伪影变得可听。320 ms 的块是甜点。
- 没有抖动缓冲区。 真实网络是有抖动的;不做平滑就会有爆破音。
- 单次错误处理。 音频 pipeline 必须防崩溃。一个异常就会杀死会话。
交付它
保存为 outputs/skill-realtime-designer.md。设计一条实时音频 pipeline,并给出每个阶段的具体延迟预算。
练习
- 简单。 运行
code/main.py。模拟环形缓冲区 + 能量 VAD;为一段模拟的 10 秒流打印各阶段延迟。 - 中等。 用
sounddevice构建一个直通循环,以 20 ms 帧处理麦克风输入,并逐帧打印 VAD 状态。 - 困难。 用
aiortc构建全双工回声测试:浏览器 → WebRTC → Python → WebRTC → 浏览器。用 1 kHz 脉冲测量端到端(glass-to-glass)延迟。
关键术语
| 术语 | 人们怎么说 | 实际含义 |
|---|---|---|
| 环形缓冲区(Ring buffer) | 那个循环队列 | 固定大小、无锁(或 SPSC 加锁)的音频帧 FIFO。 |
| VAD | 静音门控 | 标记语音与非语音的模型或启发式方法。 |
| 流式 ASR | 实时 STT | 音频到达时输出部分文本;前瞻有界。 |
| 抖动缓冲区(Jitter buffer) | 网络平滑器 | 重排乱序包的队列;典型 60–80 ms。 |
| AEC | 回声消除 | 减去扬声器到麦克风的反馈路径。 |
| Barge-in | 用户打断 | 系统在 TTS 过程中检测到用户说话;必须取消播放。 |
| 全双工(Full duplex) | 双向同时 | 用户和机器人可以同时说话;Moshi 是全双工的。 |
延伸阅读
- Macháček et al. (2023). Whisper-Streaming —— 分块近流式 Whisper。
- Kyutai (2024). Moshi —— 全双工,200 ms 延迟。
- LiveKit Agents framework (2024) —— 生产级音频 Agent 编排。
- Silero VAD repo —— 亚毫秒级 VAD,Apache 2.0。
- WebRTC AEC3 paper —— 开源实现下的回声消除。
示意图共 1 张