问题
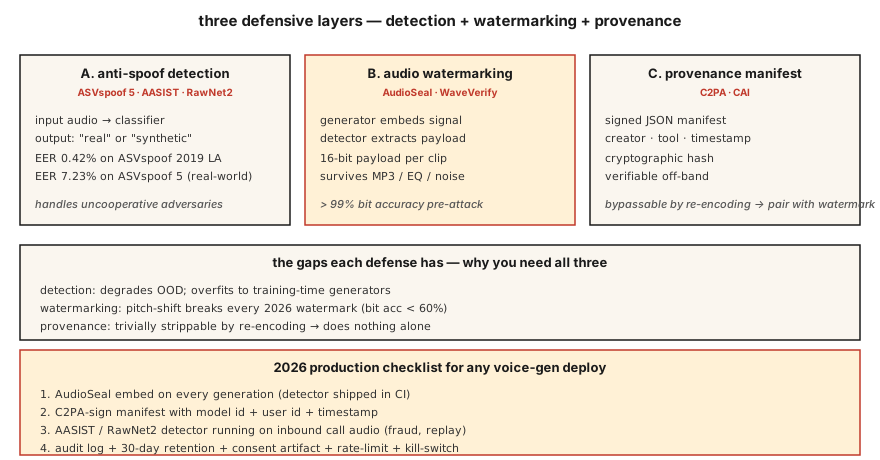
三个相关的防御:
- 反欺骗/深度伪造检测。 给定一个音频片段,它是合成的还是真实的?ASVspoof 基准(ASVspoof 2019 → 2021 → 5)是黄金标准。
- 音频水印。 在生成音频中嵌入不可察觉的信号,让检测器以后能提取。AudioSeal(Meta)和 WavMark 是开源选项。
- 可认证的来源。 对音频文件 + 元数据进行密码学签名。C2PA / Content Authenticity Initiative。
检测应对不合作的对手。水印应对合规——AI 生成的音频应当可被识别为 AI 生成。2026 年两者都需要。
概念
ASVspoof 5 —— 2024-2025 基准
与之前版本相比最大的变化:
- 众包数据(不是录音棚干净数据)——真实条件。
- 约 2000 名说话人(此前约 100)。
- 32 种攻击算法。 TTS + 语音转换 + 对抗扰动。
- 两个赛道。 对策(CM)独立检测;面向生物识别系统的抗欺骗 ASV(SASV)。
ASVspoof 5 上的 SOTA:约 7.23% EER。在更早的 ASVspoof 2019 LA 上:0.42% EER。真实部署:野外片段预期 5-10% EER。
AASIST 与 RawNet2 —— 检测模型家族
AASIST(2021,更新至 2026)。对频谱特征做图注意力。ASVspoof 5 对策任务上的当前 SOTA。
RawNet2。 原始波形上的卷积前端 + TDNN 主干。更简单的基线;微调后仍有竞争力。
NeXt-TDNN + SSL 特征。 2025 变体:ECAPA 风格 + WavLM 特征 + focal loss。在 ASVspoof 2019 LA 上达到 0.42% EER。
AudioSeal —— 2024 年水印的默认选择
Meta 的 AudioSeal(2024 年 1 月,v0.2 2024 年 12 月)。关键设计:
- 局部化。 在 16 kHz 采样分辨率(1/16000 s)上逐帧检测水印。
- 生成器 + 检测器联合训练。 生成器学习嵌入不可听信号;检测器学习在增强后找到它。
- 鲁棒。 能经受 MP3 / AAC 压缩、EQ、±10% 变速、+10 dB SNR 噪声混合。
- 快速。 检测器以 485 倍实时运行;比 WavMark 快 1000 倍。
- 容量。 每段话语可嵌入 16 比特负载(可编码模型 ID、生成时间戳、用户 ID)。
WavMark
AudioSeal 之前的开源基线。可逆神经网络,32 比特/秒。问题:
- 同步暴力搜索很慢。
- 可被高斯噪声或 MP3 压缩移除。
- 对实时不友好。
WaveVerify(2025 年 7 月)
解决 AudioSeal 的弱点——特别是时间操作(倒放、变速)。使用基于 FiLM 的生成器 + 专家混合(MoE)检测器。在标准攻击上与 AudioSeal 竞争;能处理时间编辑。
对手利用的缺口
来自 AudioMarkBench:「在变调下,所有水印的比特恢复准确率都低于 0.6,表明几乎被完全移除。」变调是通用攻击。 2026 年没有水印对激进的音高修改完全鲁棒。这就是为什么你需要检测(AASIST)与水印并存。
C2PA / Content Authenticity Initiative
不是 ML 技术——是一种清单格式。音频文件携带关于创建工具、作者、日期的密码学签名元数据。Audobox / Seamless 使用它。对来源证明有好处;如果坏人重新编码并剥离元数据,它就毫无作用。
构建它
第 1 步:简单的频谱特征检测器(玩具)
pythondef spectral_rolloff(spec, percentile=0.85):
cum = 0
total = sum(spec)
if total == 0:
return 0
threshold = total * percentile
for k, v in enumerate(spec):
cum += v
if cum >= threshold:
return k
return len(spec) - 1
def is_suspicious(audio):
spec = magnitude_spectrum(audio)
rolloff = spectral_rolloff(spec)
return rolloff / len(spec) > 0.92合成语音通常有异常平坦的高频能量。生产检测器使用 AASIST,而不是这个。但直觉成立。
第 2 步:AudioSeal 嵌入 + 检测
pythonfrom audioseal import AudioSeal
import torch
generator = AudioSeal.load_generator("audioseal_wm_16bits")
detector = AudioSeal.load_detector("audioseal_detector_16bits")
audio = load_wav("generated.wav", sr=16000)[None, None, :]
payload = torch.tensor([[1, 0, 1, 1, 0, 1, 0, 0, 1, 1, 0, 1, 0, 1, 1, 0]])
watermark = generator.get_watermark(audio, sample_rate=16000, message=payload)
watermarked = audio + watermark
result, decoded_payload = detector.detect_watermark(watermarked, sample_rate=16000)
# result: float in [0, 1] — probability of watermark presence
# decoded_payload: 16 bits; match against embedded payload第 3 步:评估 —— EER
pythondef eer(real_scores, fake_scores):
thresholds = sorted(set(real_scores + fake_scores))
best = (1.0, 0.0)
for t in thresholds:
far = sum(1 for s in fake_scores if s >= t) / len(fake_scores)
frr = sum(1 for s in real_scores if s < t) / len(real_scores)
if abs(far - frr) < best[0]:
best = (abs(far - frr), (far + frr) / 2)
return best[1]第 4 步:生产集成
pythondef safe_tts(text, voice, clone_reference=None):
if clone_reference is not None:
verify_consent(user_id, clone_reference)
audio = tts_model.synthesize(text, voice)
audio_with_wm = audioseal_embed(audio, payload=build_payload(user_id, model_id))
manifest = c2pa_sign(audio_with_wm, user_id, timestamp=now())
return audio_with_wm, manifest每次生成都交付:(1) 水印,(2) 签名清单,(3) 符合保留策略的审计日志。
使用它
| 用例 | 防御 |
|---|---|
| 交付 TTS / 语音克隆 | 每个输出都嵌入 AudioSeal(不可协商) |
| 生物识别语音解锁 | AASIST + ECAPA 集成;活体挑战 |
| 呼叫中心欺诈检测 | 对 20% 的来电抽样跑 AASIST |
| 播客真实性 | 上传时 C2PA 签名,AI 生成时加 AudioSeal |
| 研究 / 训练检测器 | ASVspoof 5 训练/开发/评估集 |
陷阱
- 有水印但检测器从不运行。 毫无意义。把检测器装进你的 CI。
- 检测没有校准。 在 ASVspoof LA 上训练的 AASIST 会过拟合;真实世界准确率下降。在你的领域上校准。
- 变调缺口。 激进的变调会移除大多数水印。要有检测回退。
- 元数据剥离重托管。 C2PA 通过重新编码就能轻易绕过。始终同时加入密码学 + 感知(水印)防御。
- 把活体检测当检测。 要求用户说一句随机短语。防重放攻击,但不防实时克隆。
交付它
保存为 outputs/skill-spoof-defender.md。为语音生成部署选择检测模型、水印、来源清单和运营手册。
练习
- 简单。 运行
code/main.py。在合成音频上做玩具检测器 + 玩具水印嵌入/检测。 - 中等。 安装
audioseal,在 TTS 输出中嵌入 16 比特负载,再解码。用噪声损坏音频并测量比特恢复准确率。 - 困难。 在 ASVspoof 2019 LA 上微调 RawNet2 或 AASIST。测量 EER。在一个留出的 F5-TTS 生成片段集上测试——看 OOD 检测如何退化。
关键术语
| 术语 | 人们怎么说 | 实际含义 |
|---|---|---|
| ASVspoof | 那个基准 | 两年一次的挑战赛;2024 = ASVspoof 5。 |
| CM(countermeasure) | 检测器 | 分类器:真实语音 vs 合成/转换语音。 |
| SASV | 说话人验证 + CM | 集成的生物识别 + 欺骗检测。 |
| AudioSeal | Meta 水印 | 局部化、16 比特负载、比 WavMark 快 485 倍。 |
| Bit Recovery Accuracy | 水印存活率 | 攻击后恢复的负载比特比例。 |
| C2PA | 来源清单 | 关于创建/作者的密码学元数据。 |
| AASIST | 检测器家族 | 基于图注意力的反欺骗 SOTA。 |
进一步阅读
- Todisco et al. (2024). ASVspoof 5 —— 当前基准。
- Defossez et al. (2024). AudioSeal —— 水印默认选择。
- Chen et al. (2025). WaveVerify —— 面向时间攻击的 MoE 检测器。
- Jung et al. (2022). AASIST —— SOTA 检测主干。
- AudioMarkBench (2024) —— 鲁棒性评估。
- C2PA specification —— 来源清单格式。
示意图共 1 张