问题
用户说出一句口令。你想知道:这是不是他声称的那个人(验证,1:1),还是你的注册库中的第一个人(识别,1:N)?或者都不是——这是一个未知说话人(开集)?
2018 年之前:GMM-UBM + i-vector。EER 尚可,但对通道偏移(手机 vs 笔记本)和情绪很脆弱。2018–2022:x-vector(用角度 margin 训练的 TDNN 骨干)。2022 年之后:ECAPA-TDNN 与 WavLM-large 嵌入。到 2026 年,这个领域由三个模型和一个指标主导。
这个指标是 EER——等错误率(Equal Error Rate)。调整你的决策阈值,使误接受率(False Accept Rate)= 误拒绝率(False Reject Rate)。两者的交点就是 EER。每篇论文、每张排行榜、每次采购决策都会用到它。
概念
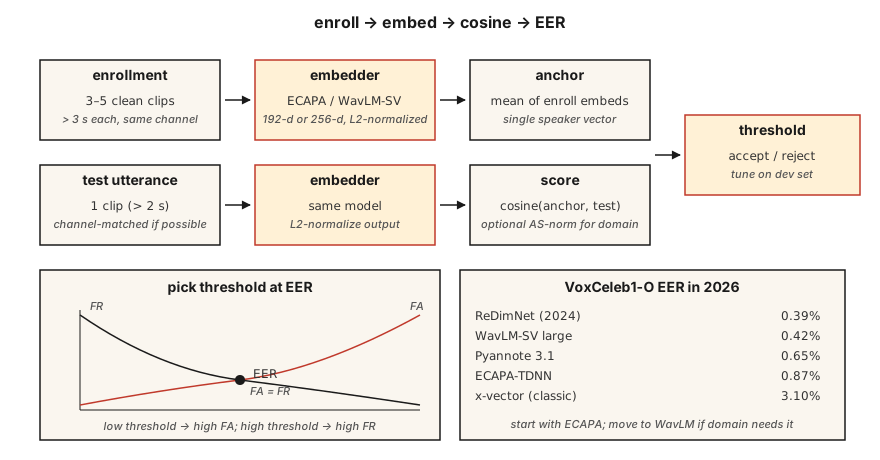
Pipeline。 注册:录制目标说话人 5–30 秒的音频;计算固定维度嵌入(ECAPA-TDNN 为 192 维,WavLM-large 为 256 维)。验证:获取测试话语的嵌入;计算余弦相似度;与阈值比较。
ECAPA-TDNN(2020 年,2026 年仍占主导)。 Emphasized Channel Attention, Propagation and Aggregation - Time-Delay Neural Network。1D 卷积块带 squeeze-excitation,多头注意力池化,后接一个线性层输出 192 维。在 VoxCeleb 1+2(2,700 位说话人、110 万条话语)上用加性角度 margin 损失(AAM-softmax)训练。
WavLM-SV(2022+)。 用 AAM 损失微调预训练的 WavLM-large SSL 骨干。质量更高但更慢——300+ MB 对 15 MB。
x-vector(基线)。 TDNN + 统计池化。经典方法;在 CPU / 边缘设备上仍有用。
AAM-softmax。 标准 softmax,在角度空间中为正确类别加上 margin m:cos(θ + m)。强制类间角度分离。典型值 m=0.2,scale s=30。
打分
- 余弦:在注册嵌入与测试嵌入之间计算。基于阈值做决策。
- PLDA(概率 LDA)。 把嵌入投影到隐空间,在那里同说话人 vs 不同说话人具有闭式似然比。叠加在余弦之上可再降低 10–20% 的 EER。2020 年之前是标准做法;现在只用于闭集场景。
- 分数归一化。
S-norm或AS-norm:用冒充者群体的均值与标准差归一化每个分数。跨域评估时必不可少。
2026 年你应该知道的数字
| 模型 | VoxCeleb1-O EER | 参数 | 吞吐量(A100) |
|---|---|---|---|
| x-vector(经典) | 3.10% | 5 M | 400× RT |
| ECAPA-TDNN | 0.87% | 15 M | 200× RT |
| WavLM-SV large | 0.42% | 316 M | 20× RT |
| Pyannote 3.1 分割 + 嵌入 | 0.65% | 6 M | 100× RT |
| ReDimNet(2024) | 0.39% | 24 M | 100× RT |
说话人分离(Diarization)
多说话人音频中的「谁在什么时候说话」。Pipeline:VAD → 分割 → 对每段计算嵌入 → 聚类(凝聚式或谱聚类)→ 平滑边界。现代技术栈:pyannote.audio 3.1,一次调用打包说话人分割 + 嵌入 + 聚类。2026 年 AMI 上的 SOTA DER 约为 15%(2022 年为 23%)。
构建它
第 1 步:基于 MFCC 统计量的玩具嵌入
pythondef embed_mfcc_stats(signal, sr):
frames = featurize_mfcc(signal, sr, n_mfcc=13)
mean = [sum(f[i] for f in frames) / len(frames) for i in range(13)]
std = [
math.sqrt(sum((f[i] - mean[i]) ** 2 for f in frames) / len(frames))
for i in range(13)
]
return mean + std # 26-d离 SOTA 差得很远——仅用于教学。code/main.py 在合成说话人数据上用它做概念验证。
第 2 步:余弦相似度 + 阈值
pythondef cosine(a, b):
dot = sum(x * y for x, y in zip(a, b))
na = math.sqrt(sum(x * x for x in a))
nb = math.sqrt(sum(x * x for x in b))
return dot / (na * nb) if na and nb else 0.0
def verify(enroll, test, threshold=0.75):
return cosine(enroll, test) >= threshold第 3 步:从相似度对计算 EER
pythondef eer(same_scores, diff_scores):
thresholds = sorted(set(same_scores + diff_scores))
best = (1.0, 1.0, 0.0) # (fa, fr, threshold)
for t in thresholds:
fr = sum(1 for s in same_scores if s < t) / len(same_scores)
fa = sum(1 for s in diff_scores if s >= t) / len(diff_scores)
if abs(fa - fr) < abs(best[0] - best[1]):
best = (fa, fr, t)
return (best[0] + best[1]) / 2, best[2]返回 (eer, threshold_at_eer)。两者都要报告。
第 4 步:用 SpeechBrain 落地生产
pythonfrom speechbrain.pretrained import EncoderClassifier
clf = EncoderClassifier.from_hparams(source="speechbrain/spkrec-ecapa-voxceleb")
# enroll: average the embeddings of 3-5 clean samples
enroll = torch.stack([clf.encode_batch(load(x)) for x in enrollment_clips]).mean(0)
# verify
score = clf.similarity(enroll, clf.encode_batch(load("test.wav"))).item()
verdict = score > 0.25 # ECAPA typical threshold; tune on your data第 5 步:用 pyannote 做说话人分离
pythonfrom pyannote.audio import Pipeline
pipe = Pipeline.from_pretrained("pyannote/speaker-diarization-3.1")
diarization = pipe("meeting.wav", num_speakers=None)
for turn, _, speaker in diarization.itertracks(yield_label=True):
print(f"{turn.start:.1f}–{turn.end:.1f} {speaker}")使用它
2026 年的技术栈:
| 情形 | 选择 |
|---|---|
| 闭集 1:1 验证、边缘 | ECAPA-TDNN + 余弦阈值 |
| 开集验证、云端 | WavLM-SV + AS-norm |
| 说话人分离(会议、播客) | pyannote/speaker-diarization-3.1 |
| 防欺骗(重放 / 深度伪造检测) | AASIST 或 RawNet2 |
| 超小嵌入(KWS + 注册) | Titanet-Small(NeMo) |
坑
- 通道不匹配。 在 VoxCeleb(网络视频)上训练的模型 ≠ 电话音频。始终在目标通道上评估。
- 短话语。 测试音频短于 3 秒时 EER 会急剧恶化。
- 带噪注册。 一次带噪注册就会污染锚点。使用至少 3 个干净样本并取平均。
- 跨条件使用固定阈值。 始终在来自目标领域的留出开发集上调阈值。
- 在未归一化的嵌入上做余弦。 先做 L2 归一化;否则幅值会占主导。
交付它
保存为 outputs/skill-speaker-verifier.md。选择模型、注册协议、阈值调优计划与反欺诈保障措施。
练习
- 简单。 运行
code/main.py。它构建合成的「说话人」(不同音调轮廓),完成注册,并在 100 对的试验列表上计算 EER。 - 中等。 在 30 条 VoxCeleb1 话语(5 位说话人 × 各 6 条)上使用 SpeechBrain ECAPA。分别用余弦与 PLDA 计算 EER。
- 困难。 用
pyannote.audio构建完整的注册 → 说话人分离 → 验证 pipeline。在 AMI 开发集上评估 DER。
关键术语
| 术语 | 常见说法 | 实际含义 |
|---|---|---|
| EER | 头条指标 | 误接受 = 误拒绝时的阈值。 |
| 验证(Verification) | 1:1 | 「这是 Alice 吗?」 |
| 识别(Identification) | 1:N | 「说话的人是谁?」 |
| 开集(Open-set) | 可能存在未知者 | 测试集可以包含未注册的说话人。 |
| 注册(Enrollment) | 登记 | 计算说话人的参考嵌入。 |
| AAM-softmax | 那个损失 | 带加性角度 margin 的 softmax;强制簇间分离。 |
| PLDA | 经典打分 | 概率 LDA;在嵌入之上做似然比打分。 |
| DER | 说话人分离指标 | Diarization Error Rate——漏检 + 误报 + 混淆。 |
延伸阅读
- Snyder et al. (2018). X-Vectors: Robust DNN Embeddings for Speaker Recognition —— 经典的深度嵌入论文。
- Desplanques et al. (2020). ECAPA-TDNN —— 2020–2026 年占主导的架构。
- Chen et al. (2022). WavLM: Large-Scale Self-Supervised Pre-Training for Full Stack Speech Processing —— 用于 SV 与说话人分离的 SSL 骨干。
- Bredin et al. (2023). pyannote.audio 3.1 —— 生产级说话人分离 + 嵌入技术栈。
- VoxCeleb leaderboard (updated 2026) —— 各模型当前的 EER 排名。
示意图共 1 张