问题
由第 11 + 12 课构建的每个语音 Agent 都有一个约 300-500 ms 的根本性延迟下限:VAD 触发、STT 处理、LLM 推理、TTS 生成。每个阶段都有自己的最小延迟。你可以调优和并行化,但管线的形状限制了你。
Moshi(Kyutai,2024-2026)提出了另一个问题:如果没有管线呢?如果有一个模型直接接收音频、连续输出音频,把文本当作中间「内心独白」而非必需阶段呢?
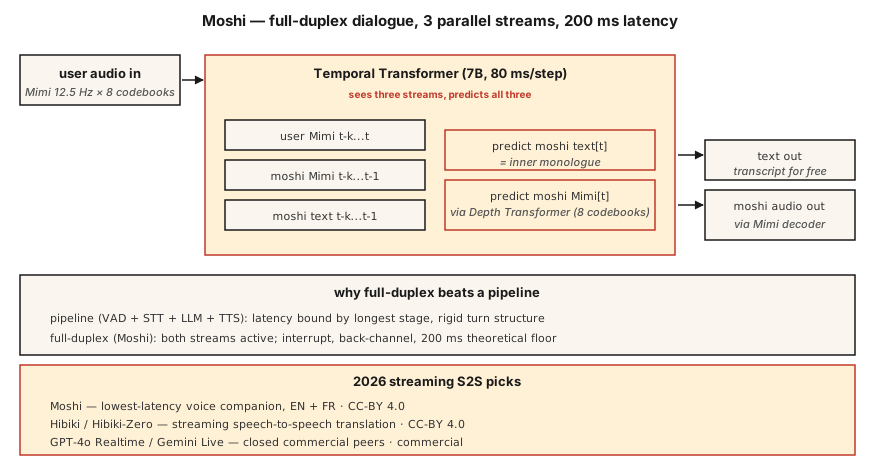
答案是全双工语音到语音(full-duplex speech-to-speech)。理论延迟 160 ms(80 ms Mimi 帧 + 80 ms 声学延迟)。在单块 L4 GPU 上实际延迟 200 ms。这是一流管线式语音 Agent 延迟的一半。
概念
Moshi 架构
输入。 两路 Mimi 编解码器流,均为 12.5 Hz × 8 码本:
- 流 1:用户音频(Mimi 编码,持续到达)
- 流 2:Moshi 自己的音频(由 Moshi 生成)
Transformer。 一个 70 亿参数的 Temporal Transformer 处理两路流和一路文本「内心独白」流。在每个 80 ms 步,它:
- 消费最新的用户 Mimi token(8 个码本)。
- 消费最近的 Moshi Mimi token(8 个码本,按产生时的样子)。
- 生成下一个 Moshi 文本 token(内心独白)。
- 生成下一个 Moshi Mimi token(通过一个小型 Depth Transformer 生成 8 个码本)。
三路流——用户音频、Moshi 音频、Moshi 文本——并行运行。Moshi 可以在说话的同时听到用户;可以在用户打断时打断自己;可以在不打断主话语的情况下发出附和(「嗯哼」)。
Depth Transformer。 在一帧之内,8 个码本不是并行预测的——它们之间存在码本间依赖。一个小的 2 层「Depth Transformer」在 80 ms 内依次预测它们。这是 AR 编解码器 LM 的标准因式分解(VALL-E、VibeVoice 也使用)。
为什么内心独白文本有帮助
没有显式文本时,模型不得不在其声学流中隐式地建模语言。Moshi 的洞见:强制它在音频之外同时输出文本 token。文本流本质上就是 Moshi 所说内容的转写。这提高了语义连贯性,使替换语言模型头更容易,还免费给你转写。
Hibiki:流式语音到语音翻译
相同架构,在翻译对上训练。源音频输入,目标语言音频连续输出。Hibiki-Zero(2026 年 2 月)消除了对词级对齐训练数据的需要——使用句级数据 + GRPO 强化学习来优化延迟。
最初支持四个语言对;用约 1000 小时即可适配一种新语言。
更广阔的 Kyutai 栈(2026)
- Moshi —— 全双工对话(法语优先,英语支持良好)
- Hibiki / Hibiki-Zero —— 同声语音翻译
- Kyutai STT —— 流式 ASR(500 ms 或 2.5 s 前瞻)
- Kyutai Pocket TTS —— 1 亿参数 TTS,在 CPU 上运行(2026 年 1 月)
- Unmute —— 在公开服务器上组合这些的完整管线
在 L40S GPU 上的吞吐量:64 个并发会话,3 倍实时。
Sesame CSM —— 表亲
Sesame CSM(2025)使用类似思路——Llama-3 主干加 Mimi 编解码器头。但 CSM 是单向的(接收上下文 + 文本,产生语音),而非全双工。它是市场上「声音存在感」最好的 TTS;与 Moshi 的全双工能力不完全相同。
2026 年性能数字
| 模型 | 延迟 | 用例 | 许可证 |
|---|---|---|---|
| Moshi | 200 ms(L4) | 全双工英语/法语对话 | CC-BY 4.0 |
| Hibiki | 12.5 Hz 帧率 | 法语 ↔ 英语流式翻译 | CC-BY 4.0 |
| Hibiki-Zero | 相同 | 5 个语言对,无需对齐数据 | CC-BY 4.0 |
| Sesame CSM-1B | 200 ms TTFA | 上下文条件 TTS | Apache-2.0 |
| GPT-4o Realtime | ~300 ms | 闭源,OpenAI API | 商业 |
| Gemini 2.5 Live | ~350 ms | 闭源,Google API | 商业 |
构建它
第 1 步:接口
Moshi 暴露一个 WebSocket 服务器,接收 80 ms 的 Mimi 编码音频块,并返回 80 ms 的 Mimi 编码音频块。双向,持续不断。
pythonimport asyncio
import websockets
from moshi.client_utils import encode_audio_mimi, decode_audio_mimi
async def moshi_chat():
async with websockets.connect("ws://localhost:8998/api/chat") as ws:
mic_task = asyncio.create_task(stream_mic_to(ws))
spk_task = asyncio.create_task(stream_from_to_speaker(ws))
await asyncio.gather(mic_task, spk_task)第 2 步:全双工循环
pythonasync def stream_mic_to(ws):
async for chunk_80ms in mic_stream_at_12_5_hz():
mimi_tokens = encode_audio_mimi(chunk_80ms)
await ws.send(serialize(mimi_tokens))
async def stream_from_to_speaker(ws):
async for msg in ws:
mimi_tokens, text_token = deserialize(msg)
audio = decode_audio_mimi(mimi_tokens)
await play(audio)两个方向同时运行。Python asyncio 或 Rust futures 是标准传输方式。
第 3 步:训练目标(概念)
对于每个 80 ms 帧 t:
- 输入:
user_mimi[0..t]、moshi_mimi[0..t-1]、moshi_text[0..t-1] - 预测:
moshi_text[t],然后moshi_mimi[t, codebook_0..7]
文本先于音频预测(内心独白);音频在 Depth Transformer 内按码本顺序预测。
第 4 步:Moshi 赢在哪里,输在哪里
Moshi 赢在:
- 在廉价硬件上端到端低于 250 ms。
- 自然的附和和打断。
- 没有管线胶水代码。
Moshi 不赢在:
- Tool calling(没有为此训练;你需要一条单独的 LLM 路径)。
- 长推理(Moshi 是一个约 80 亿参数的对话模型,不是 Claude/GPT-4)。
- 小众话题的事实准确性。
- 大多数生产型企业用例(2026 年仍在用管线)。
使用它
| 情况 | 选择 |
|---|---|
| 最低延迟语音伴侣 | Moshi |
| 实时翻译通话 | Hibiki |
| 语音演示 / 研究 | Moshi、CSM |
| 带工具的企业 Agent | 管线(第 12 课),不是 Moshi |
| 上下文中的自定义声音 TTS | Sesame CSM |
| 任意语言的语音到语音 | GPT-4o Realtime 或 Gemini 2.5 Live(商业) |
陷阱
- Tool call 有限。 Moshi 是对话模型,不是 Agent 框架。工具场景要和管线结合。
- 特定声音条件。 Moshi 使用单个训练过的人设;克隆需要单独的训练运行。
- 语言覆盖。 法语 + 英语非常出色;其他语言有限。Hibiki-Zero 有帮助,但你仍然需要训练数据。
- 资源成本。 完整的 Moshi 会话占用一个 GPU 槽位;不是便宜的共享租户部署模式。
交付它
保存为 outputs/skill-duplex-pipeline.md。为语音 Agent 工作负载选择管线还是全双工架构,并给出理由。
练习
- 简单。 运行
code/main.py。它符号化地模拟双流 + 内心独白架构。 - 中等。 从 HuggingFace 拉取 Moshi,运行服务器,测试一次对话。测量从用户语音结束到 Moshi 响应开始的墙钟延迟。
- 困难。 拿你第 12 课的管线 Agent 与 Moshi 在 20 条匹配的测试话语上比较 P50 延迟。写出管线在架构上仍然胜出的场景。
关键术语
| 术语 | 人们怎么说 | 实际含义 |
|---|---|---|
| Full-duplex | 同时听和说 | 同一模型上两路音频流同时活跃。 |
| Inner monologue | 模型的文本流 | Moshi 在音频输出之外同时输出文本 token。 |
| Depth transformer | 码本间预测器 | 在一个 80 ms 帧内预测 8 个码本的小型 Transformer。 |
| Mimi | Kyutai 的编解码器 | 12.5 Hz × 8 码本;语义+声学;支撑 Moshi。 |
| Streaming S2S | 实时的音频 → 音频 | 逐块翻译/对话,没有管线阶段。 |
| Back-channeling | 「嗯哼」反应 | Moshi 可以在不打断自己轮次的情况下发出小的附和。 |
进一步阅读
- Défossez et al. (2024). Moshi — speech-text foundation model —— 论文。
- Kyutai Labs (2026). Hibiki-Zero —— 无需对齐数据的流式翻译。
- Sesame (2025). Crossing the uncanny valley of voice —— CSM 规格。
- Kyutai — Moshi repo —— 安装 + 服务器。
- OpenAI — Realtime API —— 闭源商业同类。
- Kyutai — Delayed Streams Modeling —— 底层 STT/TTS 框架。
示意图共 1 张