问题
把一个 784 像素的 MNIST 数字压缩成 16 个数字的编码,再重建。普通自编码器的重建 MSE 会很好,但编码空间是一团乱麻。在编码空间里随机取一个点,解码,得到的是噪声。它没有采样器,只是披着压缩模型的外衣。
你真正想要的是:(a) 编码空间是一个干净、光滑、可以采样的分布——比如各向同性高斯 \mathcal{N}(0, I);(b) 解码任何样本都能得到像样的数字;(c) 编码器和解码器仍然压缩得好。三个目标,一套架构,一个损失。
Kingma 2013 年的 VAE 是这样解决的:训练编码器输出一个分布 q(z \mid x) = \mathcal{N}(\mu(x), \sigma(x)^2),用 KL 惩罚把这个分布拉向先验 \mathcal{N}(0, I),然后在解码前从 q(z \mid x) 中采样 z。推理时丢掉编码器,采样 z \sim \mathcal{N}(0, I),解码。KL 惩罚就是让编码空间变得有结构的关键。
2026 年,VAE 很少单独交付——在原始图像质量上它已被扩散模型超越——但它是每个潜在扩散模型(SD 1/2/XL/3、Flux、AudioCraft)首选的编码器。学会 VAE,你就学会了所用图像 pipeline 中那层看不见的第一层。
概念
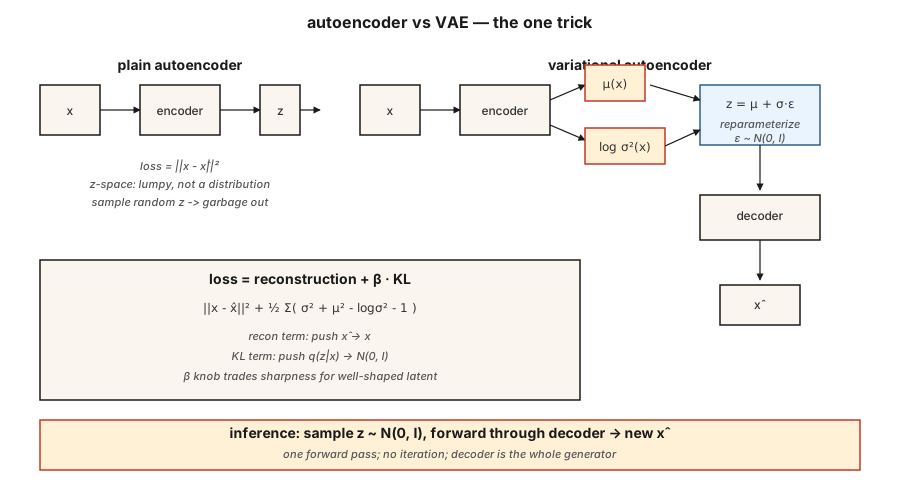
Autoencoder(自编码器)。 z = \text{encoder}(x),\hat{x} = \text{decoder}(z),损失 = \lVert x - \hat{x} \rVert^2。编码空间没有结构。
VAE 编码器。 输出两个向量:\mu(x) 和 \log \sigma^2(x)。它们定义 q(z \mid x) = \mathcal{N}(\mu, \mathop{\mathrm{diag}}(\sigma^2))。
重参数化技巧。 从 q(z \mid x) 采样不可微。把样本改写成 z = \mu + \sigma \cdot \epsilon,其中 \epsilon \sim \mathcal{N}(0, I)。这样 z 就是 (\mu, \sigma) 加上一个无参数噪声的确定性函数——梯度可以流经 μ 和 \sigma。
损失。 证据下界(ELBO),两项:
重建项把 \hat{x} 推向 x。KL 项把 q(z \mid x) 推向先验。两者相互权衡。小的 \beta(<1)得到更锐利的样本,但编码空间不那么高斯。大的 \beta(>1)得到更干净的编码空间,但样本更模糊。β-VAE(Higgins 2017)让这个旋钮出了名,并开启了 disentanglement(解耦)研究。
采样。 推理时:抽 z \sim \mathcal{N}(0, I),前向通过解码器。一次前向传播——不像扩散那样迭代采样。
构建它
code/main.py 实现了一个不用 numpy 也不用 torch 的迷你 VAE。输入是 8 维合成数据,来自 8 维空间中的双分量高斯混合。编码器和解码器都是单隐藏层 MLP。我们实现了 tanh 激活、前向传播、损失函数,以及手写的反向传播。不是生产代码——只为教学。
第 1 步:编码器前向
pythondef encode(x, enc):
h = tanh(add(matmul(enc["W1"], x), enc["b1"]))
mu = add(matmul(enc["W_mu"], h), enc["b_mu"])
log_sigma2 = add(matmul(enc["W_sig"], h), enc["b_sig"])
return mu, log_sigma2用 \log \sigma^2 而不是 \sigma,是为了让网络输出不受约束(对 σ 用 softplus 是个陷阱——当 \sigma \approx 0 时梯度会死掉)。
第 2 步:重参数化与解码
pythondef reparameterize(mu, log_sigma2, rng):
eps = [rng.gauss(0, 1) for _ in mu]
sigma = [math.exp(0.5 * lv) for lv in log_sigma2]
return [m + s * e for m, s, e in zip(mu, sigma, eps)]
def decode(z, dec):
h = tanh(add(matmul(dec["W1"], z), dec["b1"]))
return add(matmul(dec["W_out"], h), dec["b_out"])第 3 步:ELBO
pythondef elbo(x, x_hat, mu, log_sigma2, beta=1.0):
recon = sum((a - b) ** 2 for a, b in zip(x, x_hat))
kl = 0.5 * sum(math.exp(lv) + m * m - lv - 1 for m, lv in zip(mu, log_sigma2))
return recon + beta * kl, recon, kl由于两个分布都是高斯的,KL 有精确闭式解。不要做数值积分。2026 年还有人交付用蒙特卡洛估计 KL 的代码——慢 3 倍,毫无理由。
第 4 步:生成
pythondef sample(dec, z_dim, rng):
z = [rng.gauss(0, 1) for _ in range(z_dim)]
return decode(z, dec)这就是生成模型。五行。
常见陷阱
- 后验坍塌(posterior collapse)。 KL 项把 q(z \mid x) \to \mathcal{N}(0, I) 推得太狠,以至于 z 不携带任何关于 x 的信息。修复:β 退火(从 \beta=0 开始,爬升到 1)、free bits,或跳过不活跃维度上的 KL。
- 样本模糊。 高斯解码器似然隐含 MSE 重建,而 MSE 在 L2(均值)意义下是贝叶斯最优的——一组可能数字的均值就是一个模糊的数字。修复:离散解码器(VQ-VAE、NVAE),或者只把 VAE 当作编码器,在 latent 上叠加扩散(Stable Diffusion 就是这么做的)。
- β 太大、太早。 见后验坍塌。从 \beta \approx 0.01 开始,逐步升到 1。
- latent 维度太小。 16 维够 MNIST,256 维够 ImageNet 256²,2048 维够 ImageNet 1024²。Stable Diffusion 的 VAE 把 512×512×3 压缩成 64×64×4(空间面积下采样 32 倍,通道上 32 倍)。
使用它
2026 年的 VAE 技术栈:
| 场景 | 选择 |
|---|---|
| 扩散模型的图像 latent 编码器 | Stable Diffusion VAE(sd-vae-ft-ema)或 Flux VAE |
| 音频 latent 编码器 | Encodec(Meta)、SoundStream 或 DAC(Descript) |
| 视频 latent | Sora 的时空 patch、Latte VAE、WAN VAE |
| 解耦表示学习 | β-VAE、FactorVAE、TCVAE |
| 离散 latent(供 transformer 建模) | VQ-VAE、RVQ(ResidualVQ) |
| 用于生成的连续 latent | 普通 VAE,然后在该 latent 空间中条件化一个流/扩散模型 |
潜在扩散模型就是一个 VAE,只是在编码器和解码器之间住着一个扩散模型。VAE 做粗压缩,扩散模型干重活。视频(VAE + 视频扩散 DiT)和音频(Encodec + MusicGen transformer)是同样的模式。
交付它
保存 outputs/skill-vae-trainer.md。
Skill 输入:数据集概况 + 目标 latent 维度 + 下游用途(重建、采样或作为潜在扩散输入),输出:架构选择(plain/β/VQ/RVQ)、β 调度、latent 维度、解码器似然(高斯 vs 类别)、评估方案(recon MSE、每维 KL、q(z \mid x) 与 \mathcal{N}(0, I)) 之间的 Fréchet 距离)。
练习
- 简单。 把
code/main.py中的 \beta 改成0.01、0.1、1.0、5.0。记录最终的重建 MSE 和 KL。对你的合成数据来说,哪个 \beta 是帕累托最优? - 中等。 把高斯解码器似然换成伯努利似然(交叉熵损失)。在同一合成数据的二值化版本上比较样本质量。
- 困难。 把
code/main.py扩展成迷你 VQ-VAE:用一个 K=32 的码本做最近邻查表,替代连续的 z。比较重建 MSE,并报告有多少码本条目被用到(码本坍塌是真实存在的)。
关键术语
| 术语 | 常见说法 | 实际含义 |
|---|---|---|
| Autoencoder | 编码-解码网络 | x \to z \to \hat{x},学 MSE。不是生成模型。 |
| VAE | 带采样器的 AE | 编码器输出分布,KL 惩罚塑造编码空间。 |
| ELBO | 证据下界 | \log p(x) \ge \text{recon} - \mathrm{KL}[q(z \mid x) \Vert p(z)];当 q = p(z \mid x) 时取等号。 |
| Reparameterization | z = \mu + \sigma \cdot \epsilon | 把随机节点改写成确定性部分 + 纯噪声。让梯度能穿过采样。 |
| Prior | p(z) | latent 的目标分布,通常是 \mathcal{N}(0, I)。 |
| Posterior collapse | 「KL 项赢了」 | 编码器忽略 x,输出先验;解码器只能瞎编。 |
| β-VAE | 可调的 KL 权重 | \text{loss} = \text{recon} + \beta \cdot \mathrm{KL}。\beta 越大,越解耦但越模糊。 |
| VQ-VAE | 离散 latent | 用最近码本向量替换连续 z;让 transformer 建模成为可能。 |
生产说明:VAE 是扩散服务器里最热的路径
在 Stable Diffusion / Flux / SD3 pipeline 中,每次请求 VAE 会被调用两次——一次编码(如果做 img2img / inpainting),一次解码。在 1024² 下,解码器的这一趟常常是整个 pipeline 中最大的单次激活内存峰值,因为它要把 128×128×16 的 latent 上采样回 1024×1024×3。两个实际后果:
- 切片或分块解码。
diffusers提供pipe.vae.enable_slicing()和pipe.vae.enable_tiling()。分块用一点接缝伪影换取 O(\text{tile}^2) 内存,而不是 O(H \cdot W)。在消费级 GPU 上跑 1024²+ 时必不可少。 - bf16 解码器,最终 resize 用 fp32 数值。 SD 1.x 的 VAE 以 fp32 发布,在 1024²+ 下被转成 fp16 时会静默产生 NaN。SDXL 提供
madebyollin/sdxl-vae-fp16-fix——优先用 fp16-fix 变体,或者用 bf16。
延伸阅读
- Kingma & Welling(2013)。Auto-Encoding Variational Bayes — VAE 原始论文。
- Higgins 等(2017)。β-VAE: Learning Basic Visual Concepts with a Constrained Variational Framework — 解耦的 β-VAE。
- van den Oord 等(2017)。Neural Discrete Representation Learning — VQ-VAE。
- Vahdat & Kautz(2021)。NVAE: A Deep Hierarchical Variational Autoencoder — SOTA 图像 VAE。
- Rombach 等(2022)。High-Resolution Image Synthesis with Latent Diffusion Models — Stable Diffusion;VAE 作为编码器。
- Défossez 等(2022)。High Fidelity Neural Audio Compression — Encodec,音频 VAE 的标准。
示意图共 1 张