问题
像「一个穿红裙的女人在繁忙街道上遛狗」这样的 prompt,没有告诉模型狗在哪里、女人是什么姿态、街道是什么透视。文本大约只能确定描述一张图像所需信息的 10%。其余信息是视觉性的,无法用语言高效描述。
为每一种信号(姿态、深度、canny、分割)都从零训练一个新的条件模型,成本高得离谱。你希望冻结 2.6B 参数的 SDXL 骨干,挂接一个小型旁路网络来读取条件,再让它对骨干的中间特征做小幅调整。这就是 ControlNet。
你还想在不重训整个模型的情况下教模型新概念(你的脸、你的产品、你的风格)。你想要一个体积小 100 倍的增量。这就是 LoRA——插入现有注意力权重的低秩适配器。
ControlNet + LoRA + 文本 = 2026 年从业者的工具箱。大多数生产图像 pipeline 会在 SDXL / SD3 / Flux 基础模型之上叠加 2-5 个 LoRA、1-3 个 ControlNet 和一个 IP-Adapter。
概念
ControlNet(Zhang 等,2023)
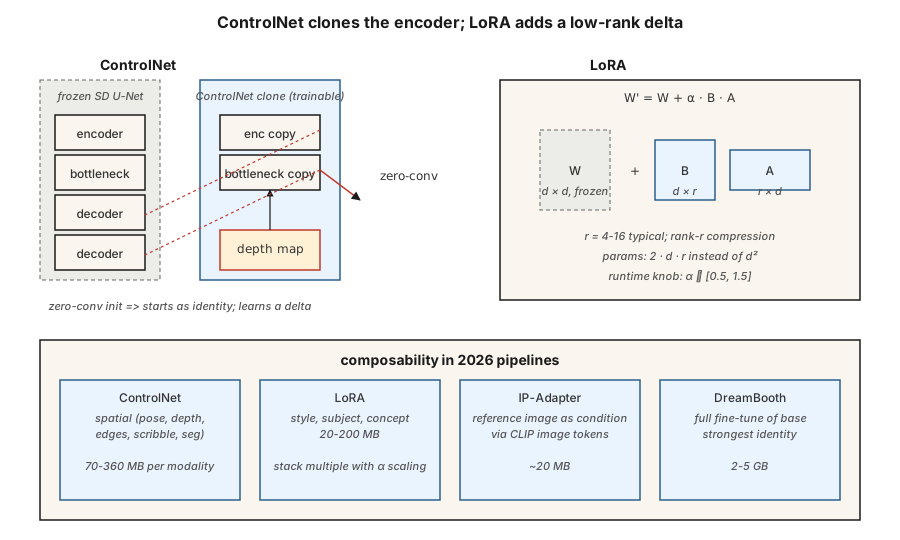
取一个预训练的 SD。克隆 U-Net 的编码器部分。冻结原版。训练克隆体接受额外的条件输入(边缘、深度、姿态)。用零卷积跳跃连接把克隆体接回原版的解码器部分(初始化为零的 1×1 卷积——起手是无操作,学出一个增量)。
SD U-Net decoder: ... ← orig_enc_features + zero_conv(controlnet_enc(condition))零卷积初始化意味着 ControlNet 起始时是恒等映射——即使在训练之前也不会造成损害。在 100 万个 (prompt, condition, image) 三元组上,用标准扩散损失训练。
各模态的 ControlNet 以小型旁路模型形式发布(SDXL 约 360M,SD 1.5 约 70M)。推理时可以把它们组合起来:
features += weight_a * control_a(depth) + weight_b * control_b(pose)LoRA(Hu 等,2021)
对模型中任意线性层 W \in \mathbb{R}^{d \times d},冻结 W 并加上一个低秩增量:
其中 r \ll d。注意力层通常用秩 4-16,重度微调用秩 64-128。新增参数数量为 2 \cdot d \cdot r 而不是 d^2。对于 d=640、r=16 的 SDXL 注意力层:每个适配器 20k 参数而不是 410k——减少 20 倍。就整个模型而言,一个 LoRA 通常是 20-200MB,而基础模型是 5GB。
推理时可以缩放 LoRA:W' = W + \alpha \cdot B A。\alpha = 0.5\text{-}1.5 属于常规范围。多个 LoRA 以相加方式叠加(当然要注意,它们之间的交互是非线性的)。
IP-Adapter(Ye 等,2023)
一个小巧的适配器,接受图像作为条件(与文本并列)。用 CLIP 图像编码器生成图像 token,把它们与文本 token 一起注入交叉注意力。每个基础模型约 20MB。让你无需 LoRA 就能「按这张参考图的风格生成图像」。
可组合性矩阵
| 工具 | 控制什么 | 大小 | 何时使用 |
|---|---|---|---|
| ControlNet | 空间结构(姿态、深度、边缘) | 70-360MB | 精确布局、构图 |
| LoRA | 风格、主体、概念 | 20-200MB | 个性化、风格 |
| IP-Adapter | 来自参考图的风格或主体 | 20MB | 文本描述不出的外观 |
| Textual Inversion | 以新 token 表示单一概念 | 10KB | 旧方案,基本被 LoRA 取代 |
| DreamBooth | 针对主体做全量微调 | 2-5GB | 强身份保持、高算力 |
| T2I-Adapter | 更轻量的 ControlNet 替代 | 70MB | 边缘设备、推理预算受限 |
ControlNet 管空间,LoRA 管语义。两者一起用。
构建它
code/main.py 在一维数据上模拟这两种机制:
- LoRA。 一个预训练的线性层 W。冻结它。训练低秩 BA,使 W + BA 匹配目标线性层。展示 r = 1 就足以完美学出秩为 1 的修正。
- ControlNet-lite。 一个「冻结的基础」预测器和一个读取额外信号的「旁路网络」。旁路网络的输出由一个初始化为零的可学习标量门控(我们这一版的零卷积)。训练时观察门控逐渐增大。
第 1 步:LoRA 数学
pythondef lora(W, A, B, x, alpha=1.0):
# W is frozen; A, B are the trainable low-rank factors.
return [W[i][j] * x[j] for i, j in ...] + alpha * (B @ (A @ x))第 2 步:零初始化的旁路网络
pythonside_out = control_net(x, condition)
gated = gate * side_out # gate initialized to 0
h = base(x) + gated在第 0 步,输出与基础模型完全一致。训练早期 gate 更新缓慢——不会出现灾难性漂移。
常见陷阱
- LoRA 缩放过度。 \alpha = 2 或 \alpha = 3 是常见的「让它更强」hack,会产出过度风格化 / 崩坏的输出。保持 \alpha \le 1.5。
- ControlNet 权重冲突。 姿态 ControlNet 权重 1.0 加深度 ControlNet 权重 1.0 通常会过冲。权重之和约等于 1.0 是安全的默认值。
- LoRA 用错基础模型。 SDXL 的 LoRA 在 SD 1.5 上会静默失效,因为注意力维度不匹配。diffusers 0.30+ 会给出警告。
- Textual Inversion 漂移。 在一个 checkpoint 上训练的 token 换到另一个上会严重漂移。LoRA 的可移植性更好。
- LoRA 权重合并与存储。 可以把 LoRA 烘焙进基础模型权重以获得更快的推理(运行时无需再做加法),但会失去运行时缩放 \alpha 的能力。两个版本都保留。
使用它
| 目标 | 2026 年 pipeline |
|---|---|
| 复现某个品牌的艺术风格 | 在约 30 张精选图像上以秩 32 训练 LoRA |
| 把本人的脸放进生成的图像 | DreamBooth 或 LoRA + IP-Adapter-FaceID |
| 特定姿态 + prompt | ControlNet-Openpose + SDXL + 文本 |
| 深度感知的构图 | ControlNet-Depth + SD3 |
| 参考图 + prompt | IP-Adapter + 文本 |
| 精确布局 | ControlNet-Scribble 或 ControlNet-Canny |
| 背景替换 | ControlNet-Seg + 图像修复(第 09 课) |
| 快速 1 步风格化 | SDXL-Turbo 上的 LCM-LoRA |
交付它
保存 outputs/skill-sd-toolkit-composer.md。这个 skill 接收一个任务(输入素材:prompt、可选参考图、可选姿态、可选深度、可选涂鸦),输出工具栈、权重,以及可复现的 seed 协议。
练习
- 简单。 在
code/main.py中把 LoRA 的秩r从 1 变到 4。秩为多少时,LoRA 能精确匹配一个秩为 2 的目标增量? - 中等。 针对两个目标变换分别训练一个 LoRA。把它们一起加载,展示其相加交互。交互在什么时候不再保持线性?
- 困难。 用 diffusers 叠加:SDXL-base + Canny-ControlNet(权重 0.8)+ 风格 LoRA(\alpha 0.8)+ IP-Adapter(权重 0.6)。随着叠加权重变化,测量 FID 与 prompt 遵循度之间的权衡。
关键术语
| 术语 | 人们的说法 | 实际含义 |
|---|---|---|
| ControlNet | 「空间控制」 | 克隆的编码器 + 零卷积跳跃连接;读取条件图像。 |
| 零卷积 | 「从恒等开始」 | 初始化为零的 1×1 卷积;ControlNet 起手是无操作。 |
| LoRA | 「低秩适配器」 | W + BA,r \ll d;参数比全量微调少 100 倍。 |
| 秩 r | 「那个旋钮」 | LoRA 的压缩程度;典型为 4-16,重度个性化用 64+。 |
| \alpha | 「LoRA 强度」 | 运行时对 LoRA 增量的缩放。 |
| IP-Adapter | 「参考图」 | 通过 CLIP 图像 token 做图像条件的小型适配器。 |
| DreamBooth | 「全量主体微调」 | 在某个主体的约 30 张图像上训练完整模型。 |
| Textual Inversion | 「新 token」 | 只学习一个新的词 embedding;旧方案,基本被取代。 |
生产笔记:LoRA 热切换、ControlNet 通道与多租户服务
一个真实的文生图 SaaS 会在同一个基础 checkpoint 上服务数百个 LoRA 和十几个 ControlNet。服务问题很像 LLM 的多租户(生产推理文献在连续批处理和 LoRAX / S-LoRA 的语境下讨论 LLM 的情形):
- 热切换 LoRA,不要合并。 把 W' = W + \alpha \cdot B \cdot A 合并进基础模型可使每步推理快约 3-5%,但会冻结 \alpha 和基础模型。把 LoRA 作为秩为 r 的增量常驻显存热切换;diffusers 提供
pipe.load_lora_weights()+pipe.set_adapters([...], adapter_weights=[...])来按请求激活。切换成本就是2 · d · r · num_layers个权重——MB 级别,亚秒级。 - 把 ControlNet 看作第二条注意力通道。 克隆的编码器与基础网络并行运行。两个权重都为 1.0 的 ControlNet = 每步多两次前向,而不是合并成一次。批大小余量会按平方级下降。每个激活的 ControlNet 按约 1.5 倍步成本做预算。
- LoRA 也可以量化。 如果你量化了基础模型(见第 07 课,8GB 上的 Flux),LoRA 增量同样可以干净地量化到 8-bit 或 4-bit。QLoRA 风格的加载让你能在 4-bit Flux 基础上叠 5-10 个 LoRA 而不爆显存。
Flux 专属:Niels 的 Flux-on-8GB notebook 把基础模型量化到 4-bit;在这个量化基础上叠加风格 LoRA(pipe.load_lora_weights("user/style-lora"),weight_name="pytorch_lora_weights.safetensors")依然可用。这是 2026 年大多数 SaaS 机构交付的配方。
延伸阅读
- Zhang, Rao, Agrawala (2023). Adding Conditional Control to Text-to-Image Diffusion Models——ControlNet。
- Hu et al. (2021). LoRA: Low-Rank Adaptation of Large Language Models——LoRA(最初面向 LLM;后来移植到扩散模型)。
- Ye et al. (2023). IP-Adapter: Text Compatible Image Prompt Adapter——IP-Adapter。
- Mou et al. (2023). T2I-Adapter: Learning Adapters to Dig Out More Controllable Ability——更轻量的 ControlNet 替代方案。
- Ruiz et al. (2023). DreamBooth: Fine Tuning Text-to-Image Diffusion Models for Subject-Driven Generation——DreamBooth。
- HuggingFace Diffusers — ControlNet / LoRA / IP-Adapter docs——参考 pipeline。
示意图共 1 张