问题
在 512² 上做像素空间扩散,意味着 U-Net 要在形状为 [B, 3, 512, 512] 的张量上运行。对于一个 500M 参数的 U-Net,每个采样步骤约 100 GFLOPS。五十步就是每张图 5 TFLOPS。用十亿张图训练,算力账单会荒谬得吓人。
这些 FLOPs 大部分都花在把感知上不重要的细节推过网络——那些有损 VAE 本可以压缩掉的高频纹理。Rombach 的想法是:先训练一次 VAE(第一阶段)并冻结它,然后把扩散完全放在 4 通道 64×64 的潜空间(第二阶段)中运行。同样的 U-Net,像素数只有 1/16,在质量相当的情况下 FLOPs 大约少 64 倍。
这就是 Stable Diffusion 的配方。SD 1.x / 2.x 在 64×64×4 潜空间上使用 860M 的 U-Net,SDXL 在 128×128×4 上使用 2.6B 的 U-Net,SD3 把 U-Net 换成了采用 flow matching 的 Diffusion Transformer(DiT)。Flux.1-dev(Black Forest Labs,2024)搭载 12B 参数的 DiT-MMDiT。它们全都运行在同一个两阶段基底上。
概念
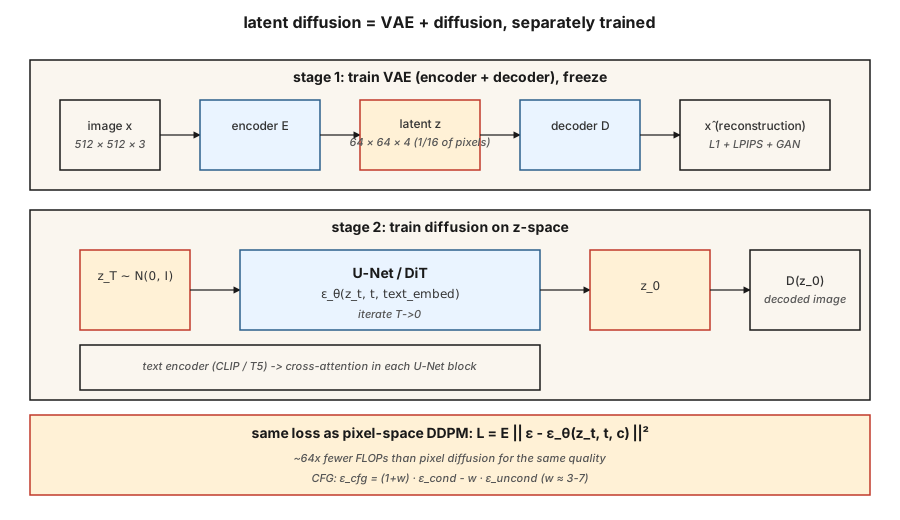
两个阶段,分开训练。
- 阶段 1——VAE。 编码器 E(x) \to z,解码器 D(z) \to x。目标压缩率:每个空间轴下采样 8×,并调整通道数,使潜变量总尺寸约为像素数的 1/16。损失 = 重建损失(L1 + LPIPS 感知损失)+ KL(权重很小,避免把 z 强行压成高斯分布,因为我们并不需要从 z 精确采样)。通常还会加对抗损失一起训练,让解码出的图像更锐利。
- 阶段 2——在 z 上做扩散。 把 z = E(x_{\text{real}}) 当作数据,训练一个 U-Net(或 DiT)为 z_t 去噪。推理时:通过扩散采样出 z_0,再计算 x = D(z_0)。
文本条件。 额外还有两个组件。一个是冻结的文本编码器(SD 1.x 用 CLIP-L,SD 2/XL 用 CLIP-L+OpenCLIP-G,SD3 和 Flux 用 T5-XXL)。另一个是交叉注意力注入:每个 U-Net 块接收 [Q = image features, K = V = text tokens],并把它们混合起来。token 是文本影响图像的唯一途径。
损失函数与第 06 课完全相同。 对噪声做同样的 DDPM / flow matching MSE。你只是换了数据域。
架构变体
| 模型 | 年份 | 骨干 | 潜空间形状 | 文本编码器 | 参数 |
|---|---|---|---|---|---|
| SD 1.5 | 2022 | U-Net | 64×64×4 | CLIP-L(77 token) | 860M |
| SD 2.1 | 2022 | U-Net | 64×64×4 | OpenCLIP-H | 865M |
| SDXL | 2023 | U-Net + refiner | 128×128×4 | CLIP-L + OpenCLIP-G | 2.6B + 6.6B |
| SDXL-Turbo | 2023 | 蒸馏版 | 128×128×4 | 同上 | 1-4 步采样 |
| SD3 | 2024 | MMDiT(多模态 DiT) | 128×128×16 | T5-XXL + CLIP-L + CLIP-G | 2B / 8B |
| Flux.1-dev | 2024 | MMDiT | 128×128×16 | T5-XXL + CLIP-L | 12B |
| Flux.1-schnell | 2024 | MMDiT 蒸馏版 | 128×128×16 | T5-XXL + CLIP-L | 12B,1-4 步 |
趋势是:用 DiT(在潜空间 patch 上运行的 Transformer)取代 U-Net,扩大文本编码器(在遵循 prompt 方面 T5 胜过 CLIP),增加潜空间通道数(4 → 16 能留出更多细节余量)。
构建它
code/main.py 在第六课的 DDPM 之上叠了一个玩具版一维「VAE」(恒等编码器 + 解码器,仅作演示;真正的 VAE 会是卷积网络),并加入带 classifier-free guidance 的类别条件。它说明了同一个扩散损失无论作用在原始一维数值还是编码后的数值上都成立——这正是关键洞察。
第 1 步:编码器/解码器
pythondef encode(x): return x * 0.5 # toy "compression" to smaller scale
def decode(z): return z * 2.0真正的 VAE 有训练好的权重。从教学角度,这个线性映射已足以说明扩散在 z 上运行,并不关心原始数据空间。
第 2 步:在 z 空间做扩散
与第六课相同的 DDPM。网络看到的数据是 z = E(x)。采样出 z_0 后用 D(z_0) 解码。
第 3 步:classifier-free guidance
训练时,以 10% 的概率丢弃类别标签(替换为 null token)。推理时分别计算 \epsilon_{\text{cond}} 和 \epsilon_{\text{uncond}},然后:
pythoneps_cfg = (1 + w) * eps_cond - w * eps_uncondw = 0 表示无引导(多样性最充分),w = 3 是默认值,w = 7+ 则过饱和 / 过度锐化。
第 4 步:文本条件(概念,不是代码)
把类别标签换成冻结文本编码器的输出。通过交叉注意力把文本 embedding 送入 U-Net:
pythonh = h + CrossAttention(Q=h, K=text_embed, V=text_embed)这就是类别条件扩散模型和 Stable Diffusion 之间唯一的实质区别。
常见陷阱
- VAE 缩放系数不匹配。 SD 1.x 的 VAE 在编码后会乘一个缩放常数(
scaling_factor ≈ 0.18215)。忘记这一步,U-Net 就会在方差严重错误的潜变量上训练。每个 checkpoint 都附带自己的系数。 - 文本编码器悄悄出错。 SD3 需要 T5-XXL 且 token 数 >=128,退回到只用 CLIP 会有信息损失。始终检查
use_t5=True,否则 prompt 保真度会大幅下降。 - 混用潜空间。 SDXL、SD3、Flux 使用的 VAE 各不相同。在 SDXL 潜变量上训练的 LoRA 无法用于 SD3。Hugging Face diffusers 0.30+ 会拒绝加载不匹配的 checkpoint。
- CFG 过高。
w > 10会生成过饱和、油腻的图像,并过度贴合 prompt 而牺牲多样性。最佳区间是w = 3-7。 - 负向 prompt 泄漏。 空的负向 prompt 会变成 null token;填了内容的负向 prompt 会变成 \epsilon_{\text{uncond}}。两者并不相同;一些 pipeline 会悄悄默认使用 null。
使用它
2026 年的生产环境技术栈:
| 目标 | 推荐骨干 |
|---|---|
| 窄领域、配对数据、从零训练模型 | SDXL 微调(LoRA / 全量)——上线最快 |
| 开放域文生图、开放权重 | Flux.1-dev(12B,Apache / 非商用)或 SD3.5-Large |
| 最快推理、开放权重 | Flux.1-schnell(1-4 步,Apache)或 SDXL-Lightning |
| 最佳 prompt 遵循、托管服务 | GPT-Image / DALL-E 3(仍是)、Midjourney v7、Imagen 4 |
| 编辑工作流 | Flux.1-Kontext(2024 年 12 月)——原生接受图像 + 文本 |
| 研究、基线 | SD 1.5——古老但研究充分 |
交付它
保存 outputs/skill-sd-prompter.md。这个 skill 接收文本 prompt + 目标风格,输出:模型 + checkpoint、CFG 缩放、采样器、负向 prompt、分辨率、可选的 ControlNet/IP-Adapter 组合,以及每一步的 QA 清单。
练习
- 简单。 用引导系数 w \in \lbrace 0, 1, 3, 7, 15 \rbrace 运行
code/main.py。记录每个类别的样本均值。当 w 达到多少时,类别均值会偏离并越过真实数据均值? - 中等。 把玩具线性编码器换成带重建损失的 tanh-MLP 编码器/解码器对。在新的潜变量上重新训练扩散。样本质量有变化吗?
- 困难。 用 diffusers 搭建真实的 Stable Diffusion 推理:加载
sdxl-base,以 CFG=7 跑 30 步 Euler,计时。然后换到sdxl-turbo,4 步、CFG=0。同样的主体,不同的质量——描述哪里变了、为什么。
关键术语
| 术语 | 人们的说法 | 实际含义 |
|---|---|---|
| 第一阶段 | 「那个 VAE」 | 训练好的编码器/解码器对;把 512² 压缩到 64²。 |
| 第二阶段 | 「那个 U-Net」 | 在潜空间上运行的扩散模型。 |
| CFG | 「引导系数」 | (1+w) \cdot \epsilon_{\text{cond}} - w \cdot \epsilon_{\text{uncond}};调节条件强度。 |
| Null token | 「空 prompt embedding」 | 用于 \epsilon_{\text{uncond}} 的无条件 embedding。 |
| 交叉注意力 | 「文本进入的方式」 | 每个 U-Net 块把文本 token 作为 K 和 V 来做注意力。 |
| DiT | 「Diffusion Transformer」 | 用 Transformer 替代 U-Net 在潜空间 patch 上运算;扩展性更好。 |
| MMDiT | 「多模态 DiT」 | SD3 的架构:文本流与图像流做联合注意力。 |
| VAE 缩放系数 | 「魔法数字」 | 把潜变量除以约 5.4,使扩散在单位方差空间中运行。 |
生产笔记:在 8GB 消费级 GPU 上运行 Flux-12B
参考版 Flux 集成是「我只有一块消费级 GPU,能不能上线?」的经典配方。窍门与生产推理文献中列出的三旋钮配方相同,只是应用到了扩散 DiT 上:
- 分阶段加载。 Flux 有三个从不需要同时驻留显存的网络:T5-XXL 文本编码器(fp32 下约 10 GB)、CLIP-L(很小)、12B 的 MMDiT,以及 VAE。先编码 prompt,然后删除编码器,加载 DiT,去噪,删除 DiT,加载 VAE,解码。消费级 8GB GPU 一次只放得下一个阶段。
- 通过 bitsandbytes 做 4-bit 量化。 在 T5 编码器和 DiT 上都使用
BitsAndBytesConfig(load_in_4bit=True, bnb_4bit_compute_dtype=torch.bfloat16)。显存降到 1/8;根据 Aritra 的基准测试(notebook 中有链接),文生图的质量下降几乎察觉不到。 - CPU offload。
pipe.enable_model_cpu_offload()会在每次前向推进时自动在 CPU 和 GPU 之间交换模块。延迟增加 10-20%,但能让 pipeline 真正跑起来。
显存账是这样的:10 GB T5 / 8 = 1.25 GB 量化后,12 B params × 0.5 bytes = ~6 GB 的量化 DiT,再加上激活值。用 stas00 的话说,这是 TP=1 推理的极端形态——没有模型并行,量化到极致。生产环境你会在 H100 上跑 TP=2 或 TP=4;单台开发笔记本上,就是这套配方。
延伸阅读
- Rombach et al. (2022). High-Resolution Image Synthesis with Latent Diffusion Models——Stable Diffusion。
- Podell et al. (2023). SDXL: Improving Latent Diffusion Models for High-Resolution Image Synthesis——SDXL。
- Peebles & Xie (2023). Scalable Diffusion Models with Transformers (DiT)——DiT。
- Esser et al. (2024). Scaling Rectified Flow Transformers for High-Resolution Image Synthesis——SD3、MMDiT。
- Ho & Salimans (2022). Classifier-Free Diffusion Guidance——CFG。
- Labs (2024). Flux.1 — Black Forest Labs announcement——Flux.1 系列。
- Hugging Face Diffusers docs——上述每个 checkpoint 的参考实现。
示意图共 1 张