问题
3D 内容很痛苦:
- 表示。 网格(mesh)、点云、体素网格、符号距离场(SDF)、神经辐射场(NeRF)、3D Gaussian。各有取舍。
- 数据稀缺。 ImageNet 有 1400 万张图像。最大的干净 3D 数据集(Objaverse-XL,2023)约有 1000 万个物体,且大多质量不高。
- 内存。 一个 512³ 的体素网格就是 1.28 亿个体素;一个可用的场景 NeRF 每条射线需要 100 万次采样。生成比重建更难。
- 监督信号。 对于 2D 图像,你有像素。对于 3D,通常只有少量 2D 视图,必须提升到 3D。
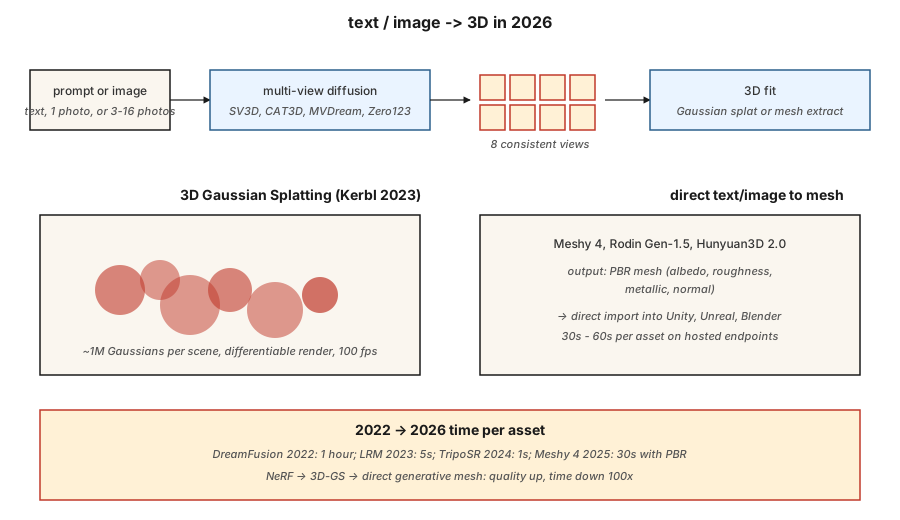
2026 年的技术栈把这两个问题分开。第一步,用扩散模型生成2D 多视图图像。第二步,用这些图像拟合一个3D 表示(通常是 Gaussian splatting)。
概念
表示:3D Gaussian Splatting(Kerbl 等,2023)
把一个场景表示为约 100 万个 3D 高斯的点云。每个高斯有 59 个参数:位置(3)、协方差(6,或四元数 4 + 缩放 3)、不透明度(1)、球谐颜色(3 阶时 48 个,0 阶时 3 个)。
渲染 = 投影 + alpha 合成。很快(4090 上 1080p 约 100 fps)。可微分。针对真实照片用梯度下降拟合。在消费级 GPU 上,一个场景 5-30 分钟即可拟合完成。
在此基础上还有两项 2023-2024 年的创新:
- 生成式 Gaussian splat。 LGM、LRM、InstantMesh 等模型直接从一张或少量图像预测高斯点云。
- 4D Gaussian Splatting。 带逐帧偏移的高斯,用于动态场景。
多视图扩散
微调预训练的图像扩散模型,从文本 prompt 或单张图像生成同一物体的多个一致视图。Zero123(Liu 等,2023)、MVDream(Shi 等,2023)、SV3D(Stability,2024)、CAT3D(Google,2024)。通常输出绕物体一圈的 4-16 个视图,再通过 Gaussian splatting 或 NeRF 提升到 3D。
文生 3D pipeline
| 模型 | 输入 | 输出 | 时间 |
|---|---|---|---|
| DreamFusion(2022) | 文本 | 经 SDS 的 NeRF | 每个资产约 1 小时 |
| Magic3D | 文本 | 网格 + 纹理 | 约 40 分钟 |
| Shap-E(OpenAI,2023) | 文本 | 隐式 3D | 约 1 分钟 |
| SJC / ProlificDreamer | 文本 | NeRF / 网格 | 约 30 分钟 |
| LRM(Meta,2023) | 图像 | triplane | 约 5 秒 |
| InstantMesh(2024) | 图像 | 网格 | 约 10 秒 |
| SV3D(Stability,2024) | 图像 | 新视角 | 约 2 分钟 |
| CAT3D(Google,2024) | 1-64 张图像 | 3D NeRF | 约 1 分钟 |
| TripoSR(2024) | 图像 | 网格 | 约 1 秒 |
| Meshy 4(2025) | 文本 + 图像 | PBR 网格 | 约 30 秒 |
| Rodin Gen-1.5(2025) | 文本 + 图像 | PBR 网格 | 约 60 秒 |
| 腾讯 Hunyuan3D 2.0(2025) | 图像 | 网格 | 约 30 秒 |
2025-2026 年的方向:直接输出可进游戏引擎的 PBR 材质文生网格模型。对于通用物体,多视图扩散的中间步骤仍是效果最好的配方。
NeRF(背景补充)
神经辐射场(Mildenhall 等,2020)。一个小型 MLP 接收 (x, y, z, view direction),输出 (color, density)。沿射线积分进行渲染。在新视角合成上质量优于基于网格的方法,但渲染慢 100-1000 倍。在大多数实时用途中已被 Gaussian splatting 取代,但在研究中仍占主导。
构建它
code/main.py 实现一个玩具版 2D「Gaussian splatting」拟合:把一张合成目标图像(平滑渐变)表示为若干 2D 高斯 splat 之和。通过梯度下降优化位置、颜色和协方差来匹配目标。你会看到两个核心操作:前向渲染(splat + alpha 合成)和用梯度下降拟合。
第 1 步:2D 高斯 splat
pythondef gaussian_at(x, y, gaussian):
px, py = gaussian["pos"]
sigma = gaussian["sigma"]
d2 = (x - px) ** 2 + (y - py) ** 2
return math.exp(-d2 / (2 * sigma * sigma))第 2 步:叠加 splat 进行渲染
pythondef render(image_size, gaussians):
img = [[0.0] * image_size for _ in range(image_size)]
for g in gaussians:
for y in range(image_size):
for x in range(image_size):
img[y][x] += g["color"] * gaussian_at(x, y, g)
return img真正的 3D Gaussian splatting 会按深度排序高斯并依次做 alpha 合成。我们的 2D 玩具版本只是求和。
第 3 步:用梯度下降拟合
pythonfor step in range(steps):
pred = render(size, gaussians)
loss = mse(pred, target)
gradients = compute_grads(pred, target, gaussians)
update(gaussians, gradients, lr)常见陷阱
- 视图不一致。 如果独立生成 4 个视图,而它们对物体结构的判断不一致,3D 拟合就会模糊。修复:使用共享注意力的多视图扩散。
- 背面幻觉。 单图到 3D 必须虚构未见的一侧。质量差异很大。
- 高斯 splat 爆炸。 无约束训练会增长到 1000 万个 splat 并过拟合。致密化 + 剪枝启发式(来自 3D-GS 原始论文)必不可少。
- 拓扑问题。 由隐式场(SDF)生成的网格常有洞或自相交。交付前跑一次重网格化(例如 Blender 的体素重网格)。
- 训练数据许可证。 Objaverse 的许可证混杂;商用性因模型而异。
使用它
| 任务 | 2026 年的选择 |
|---|---|
| 从照片重建场景 | Gaussian splatting(3DGS、Gsplat、Scaniverse) |
| 游戏用文生 3D 物体 | Meshy 4 或 Rodin Gen-1.5(PBR 输出) |
| 图生 3D | Hunyuan3D 2.0、TripoSR、InstantMesh |
| 少量图像的新视角合成 | CAT3D、SV3D |
| 动态场景重建 | 4D Gaussian Splatting |
| 虚拟形象 / 穿衣人体 | Gaussian Avatar、HUGS |
| 研究 / SOTA | 上周刚出的那个 |
要在游戏或电商 pipeline 中交付生产级 3D:Meshy 4 或 Rodin Gen-1.5 输出的 PBR 网格可以直接导入 Unity / Unreal。
交付它
保存 outputs/skill-3d-pipeline.md。这个 skill 接收 3D 简报(输入:文本 / 单张图像 / 少量图像;输出:网格 / splat / NeRF;用途:渲染 / 游戏 / VR),输出:pipeline(多视图扩散 + 拟合,或直接网格模型)、基础模型、迭代预算、拓扑后处理、所需材质通道。
练习
- 简单。 用 4、16、64 个高斯运行
code/main.py。报告相对目标的最终 MSE。 - 中等。 扩展到彩色高斯(RGB)。确认重建结果匹配目标的颜色模式。
- 困难。 用 gsplat 或 Nerfstudio,从 50 张照片的拍摄中重建一个真实物体。报告拟合时间和留出视图上的最终 SSIM。
关键术语
| 术语 | 人们的说法 | 实际含义 |
|---|---|---|
| 3D Gaussian Splatting | 「3DGS」 | 用 3D 高斯点云表示场景;可微的 alpha 合成渲染。 |
| NeRF | 「神经辐射场」 | 在 3D 点输出颜色 + 密度的 MLP;通过射线积分渲染。 |
| Triplane | 「三张 2D 平面」 | 把 3D 分解为三个轴对齐的 2D 特征网格;比体积表示更省。 |
| SDS | 「分数蒸馏采样」 | 把 2D 扩散的 score 当作伪梯度来训练 3D 模型。 |
| 多视图扩散 | 「一次多个视图」 | 输出一批一致相机视图的扩散模型。 |
| PBR | 「基于物理的渲染」 | 含 albedo、粗糙度、金属度、法线通道的材质。 |
| 致密化(Densification) | 「长出更多 splat」 | 3DGS 训练启发式:在高梯度区域拆分 / 克隆 splat。 |
生产笔记:3D 还没有共享基底
与图像(潜空间扩散 + DiT)和视频(时空 DiT)不同,3D 在 2026 年还没有单一主导的运行时。生产决策树按表示方式分叉:
- NeRF / triplane。 推理是 ray-marching + 每个采样点一次 MLP 前向。一次 512² 渲染需要数百万次 MLP 前向。要激进地批处理射线采样;SDPA/xformers 适用。
- 多视图扩散 + LRM 重建。 两阶段 pipeline。阶段 1(多视图 DiT)就是像第 07 课那样的扩散服务器。阶段 2(LRM Transformer)是对视图做一次性前向。整体延迟特征是「扩散 + 一次性前向」——据此为每个阶段选择服务原语。
- SDS / DreamFusion。 这是逐资产优化,不是推理。要建作业系统,而不是请求处理器。
对大多数 2026 年的产品,正确答案是「按请求运行多视图扩散模型,异步重建为 3DGS,再以 3DGS 提供实时观看服务」。这样就把工作负载干净地拆分到 GPU 推理服务器(快)和离线优化器(慢)之间。
延伸阅读
- Mildenhall et al. (2020). NeRF: Representing Scenes as Neural Radiance Fields——NeRF。
- Kerbl et al. (2023). 3D Gaussian Splatting for Real-Time Radiance Field Rendering——3DGS。
- Poole et al. (2022). DreamFusion: Text-to-3D using 2D Diffusion——SDS。
- Liu et al. (2023). Zero-1-to-3: Zero-shot One Image to 3D Object——Zero123。
- Shi et al. (2023). MVDream——多视图扩散。
- Hong et al. (2023). LRM: Large Reconstruction Model for Single Image to 3D——LRM。
- Gao et al. (2024). CAT3D: Create Anything in 3D with Multi-View Diffusion Models——CAT3D。
- Stability AI (2024). Stable Video 3D (SV3D)——SV3D。
示意图共 1 张