问题
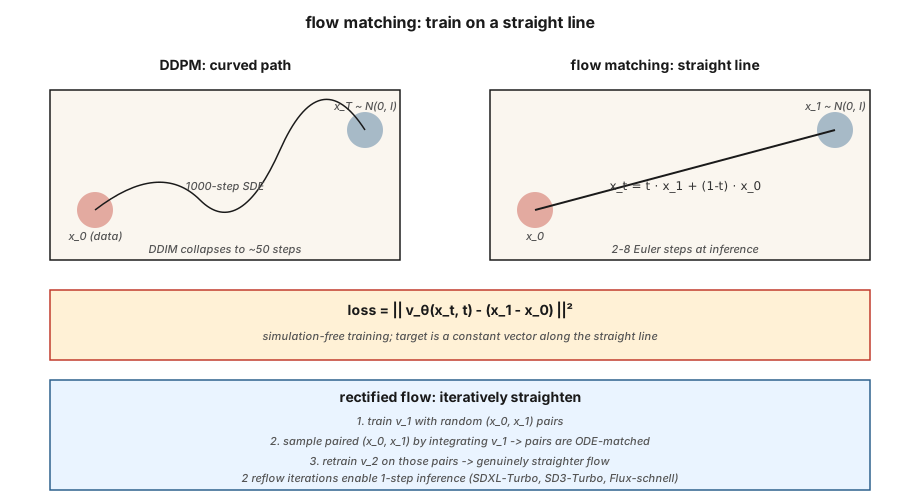
DDPM 的反向过程是一条 1000 步的随机游走,从 \mathcal{N}(0, I) 走回数据分布。DDIM 把它压缩到 20-50 个确定性步骤。你希望步数更少——理想情况下只要一步。障碍在于:求解反向过程的那个 ODE 是刚性的,路径是弯曲的。
如果你能训练模型,使从噪声到数据的路径是一条直线,那么从 t=1 到 t=0 走一步欧拉法就足够了。流匹配直接构建这条直线:定义从 x_1 \sim \mathcal{N}(0, I) 到 x_0 \sim \text{data} 的直线插值,训练一个向量场 v_\theta(x, t) 去匹配它的时间导数,推理时做积分。
整流流(Liu 2022)更进了一步:用 reflow 过程迭代地把路径拉直,得到一个逐步逼近线性的 ODE。经过两轮 reflow 之后,2 步采样器就能达到 50 步 DDPM 的质量。
概念
直线流
定义:
其中 x_0 \sim \text{data},x_1 \sim \mathcal{N}(0, I)。沿这条直线的时间导数是常数:
定义一个神经网络向量场 v_\theta(x_t, t),训练它去匹配这个导数:
这就是条件流匹配损失(Lipman 2023)。训练是免模拟的(simulation-free):你从不展开 ODE,只需采样 (x_0, x_1, t) 然后做回归。
采样
推理时,沿时间反向积分学到的向量场:
从 x_1 \sim \mathcal{N}(0, I) 出发,用欧拉步一路降到 t=0。
整流流(Liu 2022)
直线流可行,但学到的路径实际上并不直——它们会弯曲,因为多个 x_0 可能映射到同一个 x_1。整流流的 reflow 步骤是:
- 用随机配对训练流模型 v_1。
- 从 x_1 出发积分 v_1 到它的落点 x_0,以此采样 N 对 (x_1, x_0)。
- 在这些配对样本上训练 v_2。由于配对现在是「ODE 匹配」的,它们之间的直线插值确实更接近平直。
- 重复。
实践中两轮 reflow 就能达到接近线性,从而支持 2-4 步推理。SDXL-Turbo、SD3-Turbo、LCM 都是从流匹配模型蒸馏而来的。
为什么它在 2024 年赢下了图像生成
三个原因:
- 免模拟训练——训练时不需要展开 ODE,实现起来很简单。
- 更好的损失几何——直线路径的信噪比一致,而 DDPM 的 ε 损失在调度两端信噪比很差。
- 更快的推理——在 SDXL-Turbo 的质量下只需 4-8 步;配合一致性蒸馏只需 1 步。
流匹配与 DDPM——精确的联系
使用高斯条件路径的流匹配,就是采用特定噪声调度的扩散。取 x_t = \alpha(t) x_0 + \sigma(t) x_1 这一调度,流匹配就还原为 Stratonovich 重表述的扩散,且 v = \alpha' \cdot x_0 - \sigma' \cdot x_1。对于高斯路径,两者在代数上等价。
流匹配新增的是:目标的清晰性(一个普通的速度)、更干净的损失,以及尝试非高斯插值的自由。
构建它
code/main.py 在双峰高斯混合上实现一维流匹配。向量场 v_\theta(x, t) 是一个小型 MLP,用直线目标训练。推理时分别积分 1、2、4、20 个欧拉步,并比较样本质量。
第 1 步:训练损失
pythondef train_step(x0, net, rng, lr):
x1 = rng.gauss(0, 1)
t = rng.random()
x_t = t * x1 + (1 - t) * x0
target = x1 - x0
pred = net_forward(x_t, t)
loss = (pred - target) ** 2
# backprop + update第 2 步:多步推理
pythondef sample(net, num_steps):
x = rng.gauss(0, 1)
for i in range(num_steps):
t = 1.0 - i / num_steps
dt = 1.0 / num_steps
x -= dt * net_forward(x, t)
return x第 3 步:比较步数
预期 4 步采样器已经能达到 20 步的质量——这对延迟意义重大。
常见陷阱
- 时间参数化。 流匹配用 t \in [0, 1],t=0 是数据,t=1 是噪声。DDPM 用 t \in [0, T],t=0 是数据,t=T 是噪声。方向相同,尺度不同。论文里经常搞错这一点。
- 调度选择。 整流流的直线是「那个」流匹配调度,但你也可以使用余弦或 logit-normal 的 t 采样(SD3 就是这么做的)来获得更好的尺度覆盖。
- Reflow 成本。 为 reflow 生成配对数据集,每个样本都要跑一整次推理。只有确实需要 1-2 步推理时才做 reflow。
- 无分类器引导仍然适用。 只需在线性组合中把 \epsilon 换成 v:v_{\text{cfg}} = (1+w) v_{\text{cond}} - w v_{\text{uncond}}。
使用它
| 使用场景 | 2026 技术栈 |
|---|---|
| 文生图,最佳质量 | 流匹配:SD3、Flux.1-dev |
| 文生图,1-4 步 | 蒸馏流匹配:Flux.1-schnell、SD3-Turbo、SDXL-Turbo |
| 实时推理 | 从流匹配基座做一致性蒸馏(LCM、PCM) |
| 音频生成 | 流匹配:Stable Audio 2.5、AudioCraft 2 |
| 视频生成 | 流匹配混合扩散(Sora、Veo、Stable Video) |
| 科学 / 物理(粒子轨迹、分子) | 流匹配 + 等变向量场 |
2025-2026 年,只要一篇论文说「比扩散更快」,几乎总是流匹配 + 蒸馏。
交付它
保存 outputs/skill-fm-tuner.md。该 skill 接收扩散风格的模型规格,并转换为流匹配训练配置:调度选择、时间采样分布(uniform / logit-normal)、优化器、reflow 计划、目标步数、评测协议。
练习
- 简单。 运行
code/main.py,比较 1 步与 20 步采样相对真实数据分布的 MSE。 - 中等。 把均匀 t 采样换成 logit-normal(把采样集中在 t 的中段)。模型质量有提升吗?
- 困难。 实现一轮 reflow:通过积分第一个模型生成配对的 (x_0, x_1),在配对上训练第二个模型,并比较 1 步样本质量。
关键术语
| 术语 | 人们怎么说 | 实际含义 |
|---|---|---|
| Flow matching | 「直线扩散」 | 训练 v_\theta(x, t) 沿插值路径匹配 x_1 - x_0。 |
| Rectified flow | 「Reflow」 | 迭代拉直已学流的过程。 |
| Velocity field | 「v_θ」 | 模型输出——x_t 应当移动的方向。 |
| Straight-line interpolant | 「那条路径」 | x_t = (1-t) \cdot x_0 + t \cdot x_1;目标导数是平凡的。 |
| Euler sampler | 「一阶 ODE 求解器」 | 最简单的积分器;路径是直线时表现很好。 |
| Logit-normal t | 「SD3 采样」 | 把 t 采样集中到梯度最强的中段取值。 |
| Consistency distillation | 「一步采样器」 | 训练学生模型把任意 x_t 直接映射到 x_0。 |
| CFG with velocity | 「v-CFG」 | v_{\text{cfg}} = (1+w) v_{\text{cond}} - w v_{\text{uncond}};同样的技巧,换了变量。 |
生产注记:Flux.1-schnell 是流匹配的极速形态
流匹配在生产环境的胜利是 Flux.1-schnell——一个流匹配的 DiT,蒸馏到 1-4 个推理步,同时保持 Flux-dev 级别的质量。Niels 的「Run Flux on an 8GB machine」notebook 是参考部署配方:T5 + CLIP 编码,量化 MMDiT 去噪(schnell 4 步,dev 50 步),VAE 解码。成本核算如下:
| 变体 | 步数 | L4 上 1024² 的延迟 | 总 FLOPs(相对) |
|---|---|---|---|
| Flux.1-dev(原始) | 50 | ~15 s | 1.0× |
| Flux.1-schnell | 4 | ~1.2 s | 0.08×(快 12×) |
| SDXL-base | 30 | ~4 s | 0.25× |
| SDXL-Lightning 2-step | 2 | ~0.3 s | 0.03× |
生产规则:流匹配基座 + 蒸馏 = 2026 年快速文生图的默认方案。 每个主要厂商都在交付这个组合:SD3-Turbo(SD3 + flow + 蒸馏)、Flux-schnell(Flux-dev + 整流流拉直)、CogView-4-Flash。纯扩散基座只存在于遗留 checkpoint 中。
延伸阅读
- Liu, Gong, Liu (2022). Flow Straight and Fast: Learning to Generate and Transfer Data with Rectified Flow — 整流流。
- Lipman et al. (2023). Flow Matching for Generative Modeling — 流匹配。
- Esser et al. (2024). Scaling Rectified Flow Transformers for High-Resolution Image Synthesis — SD3,大规模整流流。
- Albergo, Vanden-Eijnden (2023). Stochastic Interpolants — 涵盖流匹配 + 扩散的通用框架。
- Song et al. (2023). Consistency Models — 扩散 / 流的一步蒸馏。
- Sauer et al. (2023). Adversarial Diffusion Distillation (SDXL-Turbo) — turbo 变体。
- Black Forest Labs (2024). Flux.1 models — 生产环境中的流匹配。
示意图共 1 张