问题
你想要一个 p_{\text{data}}(x) 的采样器。GAN 玩的极小极大博弈经常发散。VAE 从高斯解码器产生的样本很模糊。你真正想要的训练目标应当:(a) 是单一稳定的损失(没有鞍点,没有极小极大);(b) 是 \log p(x) 的下界(这样你有似然);(c) 产出匹配 SOTA 质量的样本。
Sohl-Dickstein 等人(2015)给出了理论答案:定义一个逐步加入高斯噪声的马尔可夫链 q(x_t \mid x_{t-1}),再训练一条逆向链 p_\theta(x_{t-1} \mid x_t) 去噪。Ho、Jain、Abbeel(2020)证明损失可以简化成一行——预测噪声——并把数学整理干净。2020 年这还是个奇趣;2021 年它产出了 SOTA 样本;2022 年它变成 Stable Diffusion;2026 年它已是底层基础。
概念
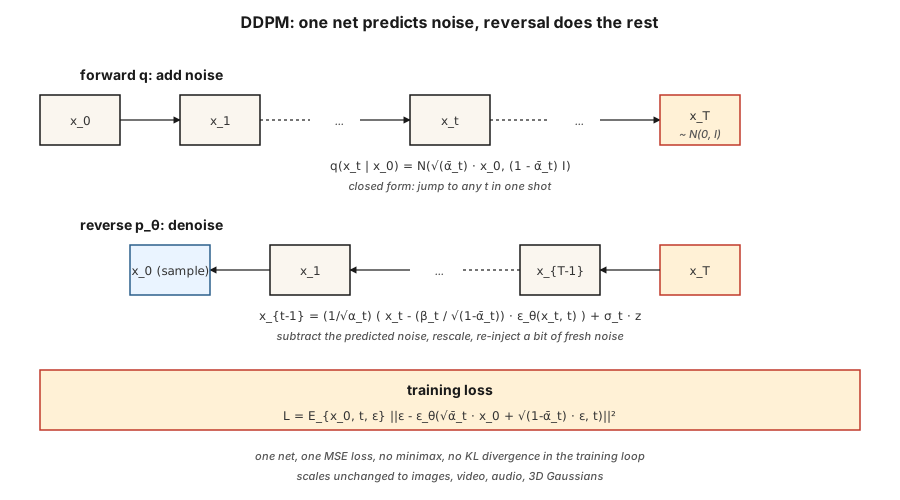
前向过程 q。 在 T 个小步中加入高斯噪声。闭式解——数学之所以可处理的原因——在于累积步也是高斯的:
其中 \bar\alpha_t = \prod_{s=1}^{t} (1 - \beta_s),对应一个 \beta_t 调度表。在 T=1000 步内把 \beta_t 从 1e-4 线性增到 0.02,x_T 就近似为 \mathcal{N}(0, I)。
逆向过程 p_\theta。 学一个神经网络 \epsilon_\theta(x_t, t) 预测所加入的噪声。给定 x_t,按下式去噪:
其中 \sigma_t 取 \sqrt{\beta_t} 或一个学出来的方差。这个式子很丑,但它只是代数——给定后验 q(x_{t-1} \mid x_t, x_0) 解出 x_{t-1},并用噪声预测得到的估计替换 x_0。
训练损失。
从数据中采样 x_0,随机取 t,采样 \epsilon \sim \mathcal{N}(0, I),用闭式解一次算出带噪的 x_t,再对噪声做回归。一个损失,没有极小极大,没有 KL,没有重参数化技巧。
采样。 从 x_T \sim \mathcal{N}(0, I) 开始。从 t = T 到 1 迭代逆向步。完成。
为什么有效
三条直觉:
- 去噪容易,生成难。 在 t=T 时,数据是纯噪声——网络要解一个平凡问题。在 t=0 时,网络只需清理几个像素。在中间的 t,问题很难,但网络有来自每个噪声水平的许多梯度流过同一组权重。
- 伪装的分数匹配。 Vincent(2011)证明,预测噪声等价于估计 \nabla_x \log q(x_t \mid x_0),即分数。逆向 SDE 用这个分数沿密度梯度上行——一场朝高概率区域的有引导随机游走。
- ELBO 化简为简单 MSE。 完整的变分下界在每个时间步都有一个 KL 项。用 DDPM 的参数化,这些 KL 项简化为噪声预测上的 MSE,只是带特定系数;Ho 丢掉了系数(称之为「simple」损失),质量反而提高了。
构建它
code/main.py 实现一个一维 DDPM。数据是双峰混合。那个「网络」是一个迷你 MLP,接收 (x_t, t),输出预测的噪声。训练就是那一行损失。采样迭代逆向链。
第 1 步:前向调度(闭式)
pythonbetas = [1e-4 + (0.02 - 1e-4) * t / (T - 1) for t in range(T)]
alphas = [1 - b for b in betas]
alpha_bars = []
cum = 1.0
for a in alphas:
cum *= a
alpha_bars.append(cum)第 2 步:一次采样 x_t
pythondef forward_sample(x0, t, alpha_bars, rng):
a_bar = alpha_bars[t]
eps = rng.gauss(0, 1)
x_t = math.sqrt(a_bar) * x0 + math.sqrt(1 - a_bar) * eps
return x_t, eps第 3 步:一个训练步
pythondef train_step(x0, model, alpha_bars, rng):
t = rng.randrange(T)
x_t, eps = forward_sample(x0, t, alpha_bars, rng)
eps_hat = model_forward(model, x_t, t)
loss = (eps - eps_hat) ** 2
return loss, gradient_step(model, ...)第 4 步:逆向采样
pythondef sample(model, alpha_bars, T, rng):
x = rng.gauss(0, 1)
for t in range(T - 1, -1, -1):
eps_hat = model_forward(model, x, t)
beta_t = 1 - alphas[t]
x = (x - beta_t / math.sqrt(1 - alpha_bars[t]) * eps_hat) / math.sqrt(alphas[t])
if t > 0:
x += math.sqrt(beta_t) * rng.gauss(0, 1)
return x对于 40 个时间步、24 单元 MLP 的一维问题,它会在约 200 个 epoch 内学会双峰混合。
时间条件
网络需要知道自己在去噪哪个时间步。两种标准做法:
- 正弦 embedding。 类似 Transformer 的位置编码。\text{embed}(t) = [\sin(t/\omega_0), \cos(t/\omega_0), \sin(t/\omega_1), \ldots]。过一层 MLP,广播进网络。
- FiLM / group-norm 条件。 把 embedding 投影成每个 block 的逐通道 scale/bias(FiLM)。
我们的玩具代码用正弦 → 拼接。生产环境的 U-Net 用 FiLM。
常见陷阱
- 调度表影响很大。 线性 \beta 是 DDPM 默认,但余弦调度(Nichol & Dhariwal, 2021)在同等算力下 FID 更好。质量停滞时就换调度。
- 时间步 embedding 很脆弱。 把原始 t 当浮点数传,对玩具一维可用,对图像会失败;始终使用正规的 embedding。
- V-prediction 与 ε-prediction。 在极端区间(t 非常小或非常大),\epsilon 的信噪比很差。V-prediction(v = \alpha \cdot \epsilon - \sigma \cdot x)更稳定;SDXL、SD3 和 Flux 都用它。
- 无分类器引导。 推理时同时计算条件和无条件的 \epsilon,然后 \epsilon_{\text{cfg}} = (1 + w) \cdot \epsilon_{\text{cond}} - w \cdot \epsilon_{\text{uncond}},w \approx 3\text{-}7。第 08 课会讲。
- 1000 步很多。 生产用 DDIM(20-50 步)、DPM-Solver(10-20 步)或蒸馏(1-4 步)。见第 12 课。
使用它
| 角色 | 2026 年的典型技术栈 |
|---|---|
| 图像像素空间扩散(小型、玩具) | DDPM + U-Net |
| 图像潜在扩散 | VAE 编码器 + U-Net 或 DiT(第 07 课) |
| 视频潜在扩散 | 时空 DiT(Sora、Veo、WAN) |
| 音频潜在扩散 | Encodec + 扩散 transformer |
| 科学(分子、蛋白质、物理) | 等变扩散(EDM、RFdiffusion、AlphaFold3) |
扩散是通用的生成骨干。流匹配(第 13 课)是 2024-2026 年的竞争者,在同等质量下通常以推理速度取胜。
交付它
保存 outputs/skill-diffusion-trainer.md。Skill 接收数据集 + 算力预算,输出:调度(linear/cosine/sigmoid)、预测目标(ε/v/x)、步数、引导尺度、采样器家族,以及评估协议。
练习
- 简单。 把
code/main.py中的 T 从 40 改成 10。样本质量(输出的可视化直方图)如何下降?T 降到多少时双峰结构会崩溃? - 中等。 从 ε-prediction 换成 v-prediction。重新推导逆向步。比较最终样本质量。
- 困难。 加入无分类器引导。以类别标签 c \in \lbrace 0, 1 \rbrace 为条件,训练时以 10% 的概率丢弃它,采样时使用 \epsilon = (1+w) \cdot \epsilon_{\text{cond}} - w \cdot \epsilon_{\text{uncond}}。测量 w = 0, 1, 3, 7 时的条件模式命中率。
关键术语
| 术语 | 常见说法 | 实际含义 |
|---|---|---|
| Forward process | 「加噪声」 | 固定的马尔可夫链 q(x_t \mid x_{t-1}),摧毁数据。 |
| Reverse process | 「去噪」 | 学出来的链 p_\theta(x_{t-1} \mid x_t),重建数据。 |
| β schedule | 「噪声阶梯」 | 每步方差;linear、cosine 或 sigmoid。 |
| α̅ | 「Alpha bar」 | 累积乘积 \prod (1 - \beta);给出从 x_0 到 x_t 的闭式解。 |
| Simple loss | 「噪声上的 MSE」 | \lVert \epsilon - \epsilon_\theta(x_t, t) \rVert^2;所有变分推导都坍缩到它。 |
| ε-prediction | 「预测噪声」 | 输出是加入的噪声;标准 DDPM。 |
| V-prediction | 「预测速度」 | 输出是 \alpha \cdot \epsilon - \sigma \cdot x;跨 t 的条件更好。 |
| DDPM | 「那篇论文」 | Ho 等 2020;线性 β、1000 步、U-Net。 |
| DDIM | 「确定性采样器」 | 非马尔可夫采样器,20-50 步,同样的训练目标。 |
| Classifier-free guidance | 「CFG」 | 混合条件与无条件的噪声预测,以放大条件作用。 |
生产说明:扩散推理是步数问题
DDPM 论文跑 T=1000 个逆向步。生产上没人这么交付。每个真实的推理栈都会选三种策略之一——而每一种都能干净地对应到生产语境下的「延迟从哪来」:
- 更快的采样器,同一个模型。 DDIM(20-50 步)、DPM-Solver++(10-20)、UniPC(8-16)。直接替换逆向循环;训练好的 \epsilon_\theta 权重不动。延迟降低 20-50 倍。
- 蒸馏。 训练一个学生模型用更少的步数匹配教师:Progressive Distillation(2 → 1)、Consistency Models(任意 → 1-4)、LCM、SDXL-Turbo、SD3-Turbo。再降 5-10 倍,需要重新训练。
- 缓存与编译。
torch.compile(unet, mode="reduce-overhead")、TensorRT-LLM 的扩散后端、xformers/SDPA 注意力、bf16 权重。每步延迟降低约 2 倍。可与 (1)、(2) 叠加。
对生产扩散服务器来说,预算讨论与生产文献描述 LLM 的方式相同:延迟是 num_steps × step_cost + VAE_decode,吞吐量是 batch_size × (num_steps × step_cost)^-1。TTFT 很小(一步);TPOT 的等价物就是完整响应时间,因为从用户视角看图像生成是「一次性完成」的。
延伸阅读
- Sohl-Dickstein 等(2015)。Deep Unsupervised Learning using Nonequilibrium Thermodynamics — 扩散论文,领先于时代。
- Ho, Jain, Abbeel(2020)。Denoising Diffusion Probabilistic Models — DDPM。
- Song, Meng, Ermon(2021)。Denoising Diffusion Implicit Models — DDIM,更少步数。
- Nichol & Dhariwal(2021)。Improved DDPM — 余弦调度,学习方差。
- Dhariwal & Nichol(2021)。Diffusion Models Beat GANs on Image Synthesis — 分类器引导。
- Ho & Salimans(2022)。Classifier-Free Diffusion Guidance — CFG。
- Karras 等(2022)。Elucidating the Design Space of Diffusion-Based Generative Models (EDM) — 统一记号,最干净的配方。
示意图共 1 张