问题
DCGAN 通过一堆转置卷积把 z 映射成图像。问题在于:z 控制一切——姿态、光照、身份、背景——全部纠缠在一起。沿 z 的某个轴移动,四项全变。你无法要求模型生成「同一个人,不同姿态」,因为表示并没有那样分解。
Karras 等人(2019,NVIDIA)提出:不要再把 z 直接喂进卷积层。把一个常数 4×4×512 张量作为网络输入。学一个 8 层 MLP,把 z \in Z \to w \in W。通过自适应实例归一化(AdaIN)在每个分辨率注入 w:先归一化每个卷积特征图,再用 w 的仿射投影做缩放和偏移。加入逐层噪声,产生随机细节(皮肤毛孔、发丝)。
结果是:W 中「高层风格」(姿态、身份)与「精细风格」(光照、颜色)的轴大致正交。你可以在两张图之间交换风格:低分辨率层级用图 A 的 w,高分辨率层级用图 B 的 w。这解锁了编辑、跨域风格化,以及整条 StyleGAN inversion(反演)研究路线。
概念
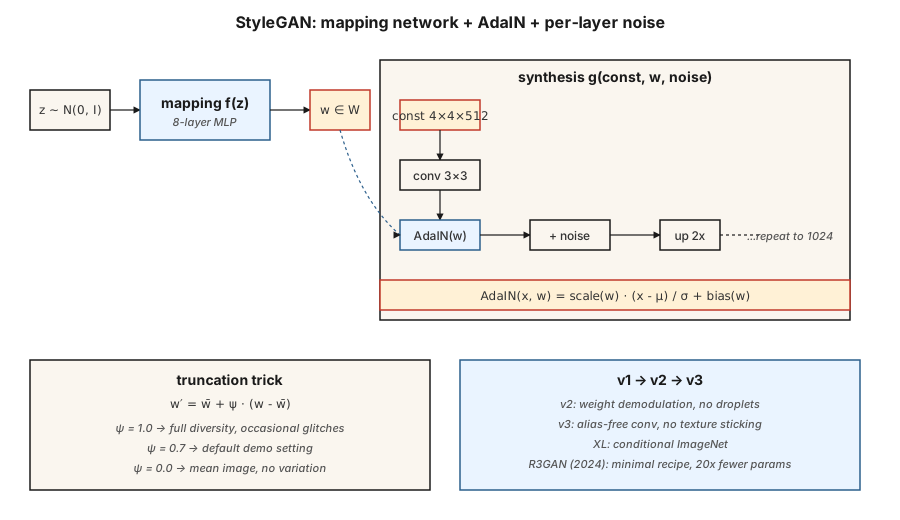
映射网络。 f: Z \to W,一个 8 层 MLP。Z = \mathcal{N}(0, I)^{512}。W 不被迫是高斯分布——它学出一个适应数据形状的分布。
合成网络。 从一个学出来的常数 4×4×512 开始。每个分辨率块:upsample → conv → AdaIN(w_i) → noise → conv → AdaIN(w_i) → noise。分辨率逐次翻倍:4、8、16、32、64、128、256、512、1024。
AdaIN。
其中 y_{\text{scale}} 和 y_{\text{bias}} 来自 w 的仿射投影。先逐特征图归一化,再重新风格化。这里的「风格」是特征图的一阶和二阶统计量。
逐层噪声。 给每个特征图加单通道高斯噪声,再乘以一个可学习的逐通道系数。它控制随机细节,不影响全局结构。
截断技巧。 推理时采样 z,计算 w = \text{mapping}(z),再取 w' = \hat{w} + \psi \cdot (w - \hat{w}),其中 \hat{w} 是大量样本上 w 的均值。\psi < 1 用多样性换质量。几乎所有 StyleGAN demo 都用 \psi \approx 0.7。
StyleGAN 1 → 2 → 3
| 版本 | 年份 | 创新 |
|---|---|---|
| StyleGAN | 2019 | 映射网络 + AdaIN + 噪声 + 渐进式增长。 |
| StyleGAN2 | 2020 | 权重解调取代 AdaIN(修复液滴伪影);跳跃/残差架构;路径长度正则化。 |
| StyleGAN3 | 2021 | 无混叠卷积 + 等变核;消除纹理粘连到像素网格。 |
| StyleGAN-XL | 2022 | 类别条件式,1024²,ImageNet。 |
| R3GAN | 2024 | 以更强的正则化重新出发;用少 20 倍的参数在 FFHQ-1024 上缩小了与扩散的差距。 |
2026 年,StyleGAN3 仍是以下场景的默认选择:(a) 高 FPS 的窄领域逼真生成;(b) 少样本域适应(用 100 张图在新数据集上训练,冻结映射网络);(c) 基于反演的编辑(找到能重建真实照片的 w,再编辑这个 w)。对于开放域文生图,它不是合适的工具——扩散才是。
构建它
code/main.py 实现一个一维的玩具「style-GAN lite」:一个映射 MLP、一个合成函数(接收学出来的常数向量,用 w 导出的 scale/bias 调制它),以及逐层噪声。它展示:通过仿射调制注入 w,效果与把 z 拼接到生成器输入相当,甚至更好。
第 1 步:映射网络
pythondef mapping(z, M):
h = z
for i in range(num_layers):
h = leaky_relu(add(matmul(M[f"W{i}"], h), M[f"b{i}"]))
return h第 2 步:自适应实例归一化
pythondef adain(x, w_scale, w_bias):
mu = mean(x)
sd = std(x)
x_norm = [(xi - mu) / (sd + 1e-8) for xi in x]
return [w_scale * xi + w_bias for xi in x_norm]每个特征图的 scale 和 bias 来自 w 的线性投影。
第 3 步:逐层噪声
pythondef add_noise(x, sigma, rng):
return [xi + sigma * rng.gauss(0, 1) for xi in x]逐通道的 sigma 可学习。
常见陷阱
- 液滴伪影(droplet artifacts)。 StyleGAN 1 在特征图里产生块状液滴,因为 AdaIN 把均值归零了。StyleGAN 2 的权重解调通过缩放卷积权重来修复。
- 纹理粘连(texture sticking)。 StyleGAN 1 和 2 的纹理会跟随像素坐标,而不是物体坐标(插值时可见)。StyleGAN 3 的无混叠卷积用加窗 sinc 滤波器修复。
- 模式覆盖。 截断
ψ < 0.7看起来干净,但样本来自一个很窄的锥体;需要多样性时用ψ = 1.0。 - 反演是有损的。 把真实照片反演成 W 通常要靠优化或编码器(e4e、ReStyle、HyperStyle)。迭代很多次后结果会漂移。
使用它
| 用例 | 方案 |
|---|---|
| 逼真人脸(动漫、产品、窄领域) | StyleGAN3 FFHQ / 自定义微调 |
| 从照片做人脸编辑 | e4e 反演 + StyleSpace / InterFaceGAN 方向 |
| 换脸 / 重演 | StyleGAN + 编码器 + 混合 |
| 数字人 pipeline | StyleGAN3 + ADA 做低数据微调 |
| 用几张图做域适应 | 冻结映射网络,微调合成网络 |
| 多模态或文本条件生成 | 不要用——改用扩散 |
对于产品级 demo,如果答案就是「一张人脸的什么照片」,在同等质量门槛下,StyleGAN 在推理成本(单次前向传播,4090 上 <10ms)和锐利度上都胜过扩散。
交付它
保存 outputs/skill-stylegan-inversion.md。Skill 接收一张真实照片,输出:反演方法(e4e / ReStyle / HyperStyle)、预期 latent 损失、编辑预算(在 W 里能走多远而不出伪影),以及一份已知可用的编辑方向清单(年龄、表情、姿态)。
练习
- 简单。 分别用
adain_on=True和adain_on=False运行code/main.py。比较固定 latent 与扰动 latent 下输出分布的范围。 - 中等。 实现混合正则化:对一个训练 batch 计算 w_a、w_b,合成的前半段用 w_a,后半段用 w_b。解码器是否学到了解耦的风格?
- 困难。 拿一个预训练的 StyleGAN3 FFHQ 模型(ffhq-1024.pkl)。在带标签的样本上训练一个 SVM,找到控制「微笑」的 w 方向;报告在身份漂移之前能推多远。
关键术语
| 术语 | 常见说法 | 实际含义 |
|---|---|---|
| Mapping network | 「那个 MLP」 | f: Z \to W,8 层,把 latent 几何与数据统计解耦。 |
| W space | 「风格空间」 | 映射网络的输出;大致解耦。 |
| AdaIN | 「自适应实例归一化」 | 归一化特征图,再用 w 投影缩放 + 偏移。 |
| Truncation trick | 「Psi」 | w = \text{mean} + \psi \cdot (w - \text{mean}),\psi<1 用多样性换质量。 |
| Path-length regularization | 「PL reg」 | 惩罚 w 单位变化引起的图像大幅变化;让 W 更平滑。 |
| Weight demodulation | 「StyleGAN2 的修复」 | 归一化卷积权重而不是激活;消除液滴伪影。 |
| Alias-free | 「StyleGAN3 的技巧」 | 加窗 sinc 滤波器;消除纹理粘连到像素网格。 |
| Inversion | 「为真实图像找 w」 | 优化或编码 x \to w,使 G(w) \approx x。 |
生产说明:为什么 StyleGAN 在 2026 年仍在交付
4090 上的 StyleGAN3 生成一张 1024² 的 FFHQ 人脸不到 10 ms——num_steps = 1,没有 VAE 解码,没有交叉注意力那一趟。用生产术语说,这是任何图像生成器的延迟下限。同分辨率的 50 步 SDXL + VAE 解码 pipeline 约 3 秒。这是 300 倍的差距,对窄领域产品(虚拟形象服务、证件照 pipeline、素材人脸生成)来说,它在总拥有成本(TCO)上胜出。
两个运营层面的后果:
- 没有调度器,没有 batcher。 按目标占用率做静态 batch 就是最优。continuous batching(对 LLM 和扩散必不可少)带来零收益,因为每个请求的 FLOPs 相同。
- 截断参数
ψ是安全旋钮。ψ < 0.7从映射网络取值范围的窄锥体中采样。这是服务层控制样本方差的唯一杠杆。高负载时调低ψ,为付费用户调高。
延伸阅读
- Karras 等(2019)。A Style-Based Generator Architecture for GANs — StyleGAN。
- Karras 等(2020)。Analyzing and Improving the Image Quality of StyleGAN — StyleGAN2。
- Karras 等(2021)。Alias-Free Generative Adversarial Networks — StyleGAN3。
- Tov 等(2021)。Designing an Encoder for StyleGAN Image Manipulation — e4e 反演。
- Sauer 等(2022)。StyleGAN-XL: Scaling StyleGAN to Large Diverse Datasets — StyleGAN-XL。
- Huang 等(2024)。R3GAN: The GAN is dead; long live the GAN! — 现代极简 GAN 配方。
示意图共 1 张