问题
生成模型的评判基于样本质量与条件遵循度。两者都没有闭式度量。你的模型必须渲染 10,000 张图像;总得有东西给它们打分;你还得让这些数字能跨模型家族、跨分辨率、跨架构地可信。2014-2026 年的层层考验之后,只有三个指标活了下来:
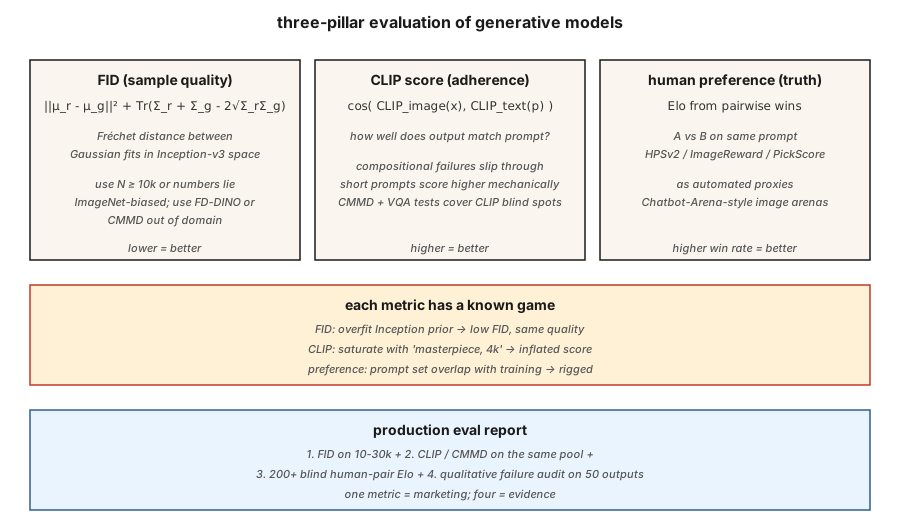
- FID(Fréchet Inception Distance)。 两个分布——真实与生成——在 Inception 网络特征空间中的距离。越低越好。
- CLIP score。 生成图像的 CLIP-image embedding 与 prompt 的 CLIP-text embedding 之间的余弦相似度。越高越好。衡量 prompt 遵循度。
- 人类偏好。 让两个模型在同一 prompt 下正面对决,由人类(或 GPT-4 级别的模型)选出更好的,再聚合成 Elo 分。
你还会看到:IS(inception score,基本已退役)、KID、CMMD、ImageReward、PickScore、HPSv2、MJHQ-30k。每一个都在修正前一个的某项失效。
概念
FID——样本质量
Heusel et al. (2017)。步骤:
- 为 N 张真实图像和 N 张生成图像提取 Inception-v3 特征(2048 维)。
- 对每个池拟合高斯分布:计算均值 \mu_r, \mu_g 和协方差 \Sigma_r, \Sigma_g。
- \text{FID} = \lVert \mu_r - \mu_g \rVert^2 + \mathop{\mathrm{Tr}}\left(\Sigma_r + \Sigma_g - 2 \cdot (\Sigma_r \cdot \Sigma_g)^{0.5}\right)。
解释:特征空间中两个多元高斯分布之间的 Fréchet 距离。越低表示分布越相似。
失效模式:
- 小 N 上有偏。 FID 是对特征分布的均方误差——小 N 会低估协方差,给出虚假偏低的 FID。始终使用 N \ge 10{,}000。
- 依赖 Inception。 Inception-v3 是在 ImageNet 上训练的。远离 ImageNet 的领域(人脸、艺术、文字图像)会产生毫无意义的 FID。应使用领域专用的特征提取器。
- 刷分。 过拟合 Inception 先验可以在视觉质量没有提升的情况下压低 FID。用 CMMD(下文)来制衡。
CLIP score——prompt 遵循度
Radford et al. (2021)。对于一张生成图像 + prompt:
clip_score = cos_sim( CLIP_image(x_gen), CLIP_text(prompt) )在 3 万张生成图像上取平均 → 得到一个可在模型之间比较的标量。
失效模式:
- CLIP 自身的盲区。 CLIP 的组合推理能力弱(「蓝色球体上的红色立方体」经常失败)。模型可以在 CLIP score 上排名很高,却并没有真正遵循复杂 prompt。
- 短 prompt 偏置。 短 prompt 在真实世界中与 CLIP-image 的匹配更多。长 prompt 在机制上 CLIP 分数更低。
- Prompt 刷分。 在 prompt 里加上 "high quality, 4k, masterpiece" 会在不改善图文绑定的情况下抬高 CLIP score。
CMMD(Jayasumana et al., 2024)修正了其中一部分:用 CLIP 特征代替 Inception,用最大均值差异代替 Fréchet。更擅长检测细微的质量差异。
人类偏好——真值基准
选择一组 prompt 池。用模型 A 和模型 B 生成。把成对结果展示给人类(或强大的 LLM 裁判)。把胜场聚合成 Elo 或 Bradley-Terry 分数。基准:
- PartiPrompts(Google):1,600 个多样化 prompt,12 个类别。
- HPSv2:10.7 万条人类标注,广泛用作自动代理。
- ImageReward:13.7 万对 prompt-图像偏好,MIT 许可。
- PickScore:在 Pick-a-Pic 的 260 万条偏好上训练。
- Chatbot-Arena 风格的图像竞技场:https://imagearena.ai/ 等。
失效模式:
- 裁判方差。 非专家与专家偏好不同。两者都要用。
- Prompt 分布。 精挑细选的 prompt 会偏向某一个模型家族。始终要记录。
- LLM 裁判的奖励黑客。 GPT-4 裁判会被漂亮但错误的输出骗过。用人类来三角验证。
配合使用
生产评测报告应包含:
- 在 10-30k 样本上、对留出真实分布的 FID(样本质量)。
- 同样样本对其 prompt 的 CLIP score / CMMD(遵循度)。
- 与上一代模型在盲测竞技场中的胜率(总体偏好)。
- 失效模式分析:随机采样 50 个输出,标记已知问题(手部解剖、文字渲染、物体数量一致性)。
任何单一指标都是谎言。三个互相印证的指标 + 定性审查才是一个论断。
构建它
code/main.py 在合成的「特征向量」上实现 FID、类 CLIP score 和 Elo 聚合(我们用 4 维向量充当 Inception 特征的替身)。你会看到:
- 小 N 与大 N 上的 FID 计算——偏置。
- 「CLIP score」作为特征池之间的余弦相似度。
- 来自合成偏好流的 Elo 更新规则。
第 1 步:四行实现 FID
pythondef fid(real_features, gen_features):
mu_r, cov_r = mean_and_cov(real_features)
mu_g, cov_g = mean_and_cov(gen_features)
mean_diff = sum((a - b) ** 2 for a, b in zip(mu_r, mu_g))
trace_term = trace(cov_r) + trace(cov_g) - 2 * sqrt_cov_product(cov_r, cov_g)
return mean_diff + trace_term第 2 步:CLIP 风格的余弦相似度
pythondef clip_like(image_feat, text_feat):
dot = sum(a * b for a, b in zip(image_feat, text_feat))
norm = math.sqrt(dot_self(image_feat) * dot_self(text_feat))
return dot / max(norm, 1e-8)第 3 步:Elo 聚合
pythondef elo_update(r_a, r_b, winner, k=32):
expected_a = 1 / (1 + 10 ** ((r_b - r_a) / 400))
actual_a = 1.0 if winner == "a" else 0.0
r_a_new = r_a + k * (actual_a - expected_a)
r_b_new = r_b - k * (actual_a - expected_a)
return r_a_new, r_b_new常见陷阱
- N=1000 的 FID。 经验法则在 N<10k 时不可靠。报告低 N FID 的论文是在刷分。
- 跨分辨率比较 FID。 Inception 的 299×299 缩放会改变特征分布。只在匹配分辨率下比较。
- 只报告一个随机种子。 至少跑 3 个种子。报告标准差。
- 通过负面 prompt 抬高 CLIP score。 一些 pipeline 通过过拟合 prompt 来提升 CLIP。检查视觉是否饱和。
- Prompt 重叠导致的 Elo 偏置。 如果两个模型在训练中都见过某基准 prompt,Elo 就毫无意义。使用留出的 prompt 集。
- 付费众包的人类评测偏差。 Prolific、MTurk 标注者偏年轻 / 偏技术。要混入招募的艺术 / 设计专家。
使用它
2026 年的生产评测协议:
| 支柱 | 最低要求 | 推荐 |
|---|---|---|
| 样本质量 | 对 10k 样本 vs 留出真实集计算 FID | + 5k 上的 CMMD + 每个类别子集的 FID |
| Prompt 遵循度 | 30k 样本上的 CLIP score | + HPSv2 + ImageReward + VQA 式问答 |
| 偏好 | 对比基线的 200 对盲测 | + 2000 对人工 + LLM 裁判 + Chatbot Arena |
| 失效分析 | 50 个手工标记 | 500 个手工标记 + 自动安全分类器 |
四个支柱齐备于一份报告 = 论断。任何单独一项 = 营销。
交付它
保存 outputs/skill-eval-report.md。该 skill 接收新的模型 checkpoint 与基线,输出完整的评测方案:样本量、指标、失效模式探针、签核标准。
练习
- 简单。 运行
code/main.py。在同一组合成分布上比较 N=100 与 N=1000 的 FID。报告偏置的幅度。 - 中等。 在合成的 CLIP 风格特征上实现 CMMD(公式见 Jayasumana et al., 2024)。比较它与 FID 对质量差异的敏感度。
- 困难。 复现 HPSv2 的设置:从 Pick-a-Pic 的一个子集中取 1000 对图像-Prompt,在偏好上微调一个小型 CLIP 评分器,并测量它与留出集的一致性。
关键术语
| 术语 | 人们怎么说 | 实际含义 |
|---|---|---|
| FID | 「Fréchet Inception Distance」 | 对真实与生成 Inception 特征的高斯拟合之间的 Fréchet 距离。 |
| CLIP score | 「图文相似度」 | CLIP 图像 embedding 与文本 embedding 之间的余弦相似度。 |
| CMMD | 「FID 的替代品」 | 基于 CLIP 特征的 MMD;偏差更小,不做高斯假设。 |
| IS | 「Inception score」 | Exp KL(p(y|x) || p(y));在现代模型上相关性很差,已退役。 |
| HPSv2 / ImageReward / PickScore | 「学出来的偏好代理」 | 在人类偏好上训练的小模型;用作自动裁判。 |
| Elo | 「国际象棋评分」 | 对成对胜负做 Bradley-Terry 聚合。 |
| PartiPrompts | 「基准提示词集」 | Google 整理的 1,600 个 prompt,覆盖 12 个类别。 |
| FD-DINO | 「自监督替代品」 | 使用 DINOv2 特征的 FD;对 ImageNet 之外的领域更好。 |
生产注记:评测同样是一种推理负载
在 10k 样本上跑 FID 意味着生成 10k 张图像。对于单张 L4 上的 50 步 SDXL base、1024²,大约是 11 小时的单请求推理。评测预算是实打实的,而这里的框架恰好就是离线推理场景(最大化吞吐量,忽略 TTFT):
- 大胆批处理,忘掉延迟。 离线评测 = 用能塞进显存的最大尺寸做静态批处理。80GB H100 上
pipe(...).images配num_images_per_prompt=8,挂钟时间比单请求快 4-6×。 - 缓存真实特征。 对真实参考集的 Inception(FID)或 CLIP(CLIP-score、CMMD)特征提取只跑一次,存成
.npz。不要每次评测都重算。
对于 CI / 回归门禁:每个 PR 在 500 样本子集上跑 FID + CLIP score(约 30 分钟);每晚跑完整的 10k FID + HPSv2 + Elo。
延伸阅读
- Heusel et al. (2017). GANs Trained by a Two Time-Scale Update Rule Converge to a Local Nash Equilibrium (FID) — FID 论文。
- Jayasumana et al. (2024). Rethinking FID: Towards a Better Evaluation Metric for Image Generation (CMMD) — CMMD。
- Radford et al. (2021). Learning Transferable Visual Models from Natural Language Supervision (CLIP) — CLIP。
- Wu et al. (2023). HPSv2: A Comprehensive Human Preference Score — HPSv2。
- Xu et al. (2023). ImageReward: Learning and Evaluating Human Preferences for Text-to-Image Generation — ImageReward。
- Yu et al. (2023). Scaling Autoregressive Models for Content-Rich Text-to-Image Generation (Parti + PartiPrompts) — PartiPrompts。
- Stein et al. (2023). Exposing flaws of generative model evaluation metrics — 失效模式综述。
示意图共 1 张