问题
三类音频生成任务:
- 文本转语音。 给定文本,产出语音。干净语音是窄带的,具有强语音学结构——用 Transformer-over-tokens 解决得很好。VALL-E(Microsoft)、NaturalSpeech 3、ElevenLabs、OpenAI TTS。
- 音乐生成。 给定 prompt(文本、旋律、和弦进行、流派),产出音乐。分布宽得多。MusicGen(Meta)、Stable Audio 2.5、Suno v4、Udio、Riffusion。
- 音效 / 声音设计。 给定 prompt,产出环境声或 Foley。AudioGen、AudioLDM 2、Stable Audio Open。
三者都跑在同一个基底上:神经音频编解码器 + token-AR 或扩散生成器。
概念
神经音频编解码器
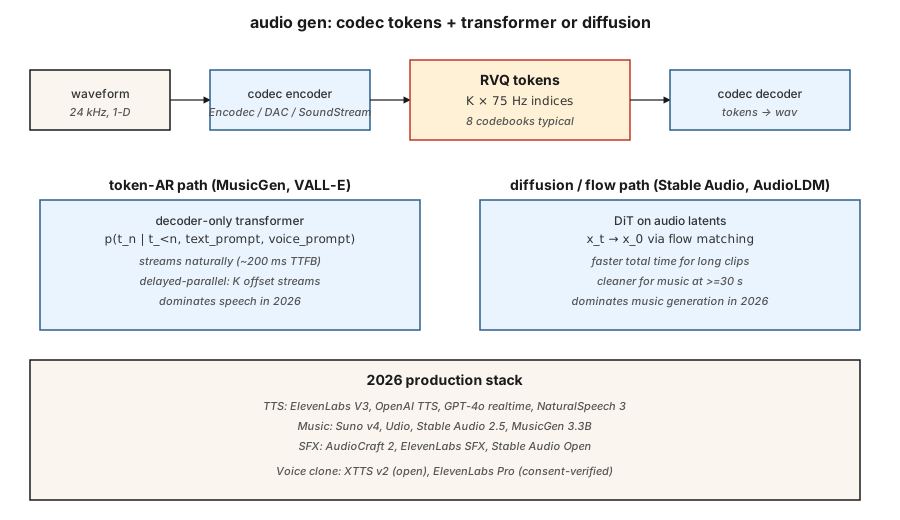
Encodec(Meta,2022)、SoundStream(Google,2021)、Descript Audio Codec(DAC,2023)。卷积编码器把波形压缩成每个时间步一个向量;残差向量量化(RVQ)把每个向量转换成一串 K 个码本索引。解码器做逆变换。24 kHz 音频在 2 kbps 下使用 8 个 RVQ 码本、75 Hz,即每秒 600 个 token。
waveform (16000 samples/sec)
└─ encoder conv ─┐
├─ RVQ layer 1 → indices at 75 Hz
├─ RVQ layer 2 → indices at 75 Hz
├─ ...
└─ RVQ layer 8其上的两种生成范式
Token 自回归。 把 RVQ token 展平成序列,跑一个 decoder-only Transformer。MusicGen 使用「延迟并行」,以每条流不同偏移的方式并行发出 K 个码本流。VALL-E 从文本 prompt + 3 秒语音样本生成语音 token。
潜空间扩散。 把 codec token 打包成连续潜变量,或用类别扩散建模。Stable Audio 2.5 在连续音频潜变量上使用 flow matching。AudioLDM 2 使用 text-to-mel-to-audio 扩散。
2024-2026 年的趋势:flow matching 在音乐上占上风(推理更快、样本更干净),而 token-AR 仍主导语音,因为它天然是因果的,流式表现好。
生产格局
| 系统 | 任务 | 骨干 | 延迟 |
|---|---|---|---|
| ElevenLabs V3 | TTS | Token-AR + 神经声码器 | 首个 token 约 300ms |
| OpenAI GPT-4o audio | 全双工语音 | 端到端多模态 AR | 约 200ms |
| NaturalSpeech 3 | TTS | 潜空间 flow matching | 非流式 |
| Stable Audio 2.5 | 音乐 / SFX | 音频潜变量上的 DiT + flow matching | 1 分钟片段约 10s |
| Suno v4 | 完整歌曲 | 未公开;推测为 token-AR | 每首歌约 30s |
| Udio v1.5 | 完整歌曲 | 未公开 | 每首歌约 30s |
| MusicGen 3.3B | 音乐 | 基于 Encodec 32kHz 的 token-AR | 实时 |
| AudioCraft 2 | 音乐 + SFX | Flow matching | 5s 片段约 5s |
| Riffusion v2 | 音乐 | 频谱图扩散 | 约 10s |
构建它
code/main.py 模拟核心思想:在由两种不同「风格」生成的合成「音频 token」序列上训练一个微型 next-token Transformer(风格 A 是低、高 token 交替,风格 B 是单调递增)。以风格为条件进行采样。
第 1 步:合成音频 token
pythondef make_tokens(style, length, vocab_size, rng):
if style == 0: # "speech-like": alternating
return [i % vocab_size for i in range(length)]
# "music-like": ramp
return [(i * 3) % vocab_size for i in range(length)]第 2 步:训练一个微型 token 预测器
一个以风格为条件的 bigram 风格预测器。重点是这条模式:codec token → 交叉熵训练 → 自回归采样。
第 3 步:条件采样
给定风格 token 和起始 token,从预测分布中采样下一个 token。持续 20-40 个 token。
常见陷阱
- 编解码器质量决定输出质量的上限。 如果编解码器无法忠实表示某种声音,生成器再好也救不回来。DAC 是目前开放方案中最好的。
- RVQ 误差累积。 每个 RVQ 层建模前一层的残差。第 1 层的误差会传播。对更高层使用 temperature 0 采样有帮助。
- 音乐结构。 30 秒的 token 在 75 Hz 下是 2 万多个 token。对 Transformer 来说很吃力。MusicGen 用滑动窗口 + prompt 续写;Stable Audio 用更短的片段 + 交叉淡化。
- 边界伪影。 生成片段之间的交叉淡化需要仔细的重叠相加。
- 对干净数据的渴求。 音乐生成器需要数万小时有授权的音乐。Suno / Udio 的 RIAA 诉讼(2024)把这个问题摆上了台面。
- 声音克隆伦理。 3 秒样本加一段文本 prompt,就足以让 VALL-E / XTTS / ElevenLabs 克隆声音。每个生产模型都需要滥用检测 + opt-out 名单。
使用它
| 任务 | 2026 年技术栈 |
|---|---|
| 商业 TTS | ElevenLabs、OpenAI TTS 或 Azure Neural |
| 声音克隆(已验证同意) | XTTS v2(开源)或 ElevenLabs Pro |
| 背景音乐,快速 | Stable Audio 2.5 API、Suno 或 Udio |
| 带歌词的音乐 | Suno v4 或 Udio v1.5 |
| 音效 / Foley | AudioCraft 2、ElevenLabs SFX 或 Stable Audio Open |
| 实时语音 Agent | GPT-4o realtime 或 Gemini Live |
| 开放权重音乐研究 | MusicGen 3.3B、Stable Audio Open 1.0、AudioLDM 2 |
| 配音 / 翻译 | HeyGen、ElevenLabs Dubbing |
交付它
保存 outputs/skill-audio-brief.md。这个 skill 接收音频简报(任务、时长、风格、声音、许可证),输出:模型 + 托管方案、prompt 格式(流派标签、风格描述词、结构标记)、codec + 生成器 + 声码器链路、seed 协议,以及评估方案(MOS / CLAP 分数 / TTS 的 CER / 用户 A/B)。
练习
- 简单。 运行
code/main.py并显式设置风格。验证生成的序列符合该风格的模式。 - 中等。 加入延迟并行解码:模拟 2 条必须保持 1 步偏移的 token 流。训练一个联合预测器。
- 困难。 用 HuggingFace transformers 在本地运行 MusicGen-small。用三种不同的 prompt 生成 10 秒片段;对风格遵循度做 A/B。
关键术语
| 术语 | 人们的说法 | 实际含义 |
|---|---|---|
| Codec | 「神经压缩」 | 音频的编码器 / 解码器;典型输出是 50-75 Hz 的 token。 |
| RVQ | 「残差 VQ」 | K 个量化器的级联;每个建模前一个的残差。 |
| Token | 「一个 codec 符号」 | 码本中的离散索引;典型为 1024 或 2048。 |
| 延迟并行(Delayed parallel) | 「偏移码本」 | 以交错偏移发出 K 条 token 流,以缩短序列长度。 |
| Flow matching | 「2024 年音频的赢家」 | 比扩散路径更直的替代方案;采样更快。 |
| 声音 prompt | 「3 秒样本」 | 引导克隆声音的说话人 embedding 或 token 前缀。 |
| Mel 频谱图 | 「那张图」 | 对数幅度的感知频谱图;许多 TTS 系统使用。 |
| 声码器(Vocoder) | 「mel 到波形」 | 把 Mel 频谱图转换回音频的神经组件。 |
生产笔记:音频是流式问题
在所有输出模态中,音频是用户唯一期望边生成边到达的模态,而不是一次性给全。用生产的话说,这意味着 TPOT(Time Per Output Token)很重要,因为目标吞吐量取决于用户的聆听速度——而不是阅读速度。对于按约 75 token/秒(Encodec)分词的 16kHz 音频,服务器必须为每个用户每秒生成 ≥75 个 token,才能保证播放流畅。
两个架构上的后果:
- Flow-matching 音频模型无法轻松流式化。 Stable Audio 2.5 和 AudioCraft 2 一次渲染固定长度的片段。要流式输出,只能分段并对边界做重叠——类似滑动窗口扩散——相比 codec AR 模型增加 100-300ms 的延迟开销。
如果产品是「实时语音聊天」或「实时音乐续写」,选 codec AR 路线。如果是「提交后渲染 30 秒片段」,flow matching 在质量和总延迟上都胜出。
延伸阅读
- Défossez et al. (2022). Encodec: High Fidelity Neural Audio Compression——codec 标准。
- Zeghidour et al. (2021). SoundStream——首个被广泛使用的神经音频编解码器。
- Kumar et al. (2023). High-Fidelity Audio Compression with Improved RVQGAN (DAC)——DAC。
- Wang et al. (2023). Neural Codec Language Models are Zero-Shot Text to Speech Synthesizers (VALL-E)——VALL-E。
- Copet et al. (2023). Simple and Controllable Music Generation (MusicGen)——MusicGen。
- Liu et al. (2023). AudioLDM 2: Learning Holistic Audio Generation with Self-supervised Pretraining——AudioLDM 2。
- Stability AI (2025). Stable Audio 2.5——2025 年采用 flow matching 的文生音乐模型。
示意图共 1 张