问题
模型读入一种语言的一句话,产出另一种语言的一句话。长度会变,语序会变。有些源词对应多个目标词,反过来也一样。习语拒绝一一映射。「I miss you」在法语里是「tu me manques」——字面意思是「你对我来说是缺失的」。任何词级对齐都撑不住这种转换。
机器翻译这个任务,逼着 NLP 发明了编码器-解码器、注意力、Transformer,最终是整个 LLM 范式。每一次前进都源于同一个原因:翻译质量可以被度量,而人与机器之间的差距又格外顽固。
本课跳过历史课,直接讲 2026 年可用的 pipeline:预训练多语言编码器-解码器(NLLB-200 或 mBART)、子词分词、beam search、BLEU 与 chrF 评估,以及少数至今仍会悄悄流入生产的失败模式。
概念
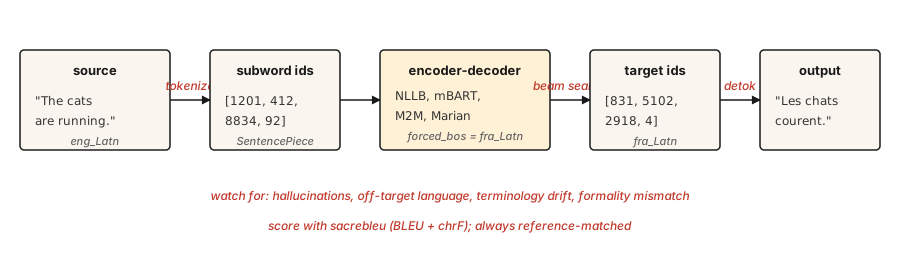
现代 MT 是在平行语料上训练的 Transformer 编码器-解码器。编码器按源语言的分词方式读入源句。解码器借助交叉注意力(第 10 课)使用编码器的输出,一次一个子词地生成目标句。解码使用 beam search,避免贪心解码的陷阱。输出经过反分词、恢复大小写,再与参考译文比对打分。
真正决定实际 MT 质量的是三个运行层面的选择。
- 分词器。 在混合语言语料上训练的 SentencePiece BPE。跨语言共享词表,正是 NLLB 能支持零样本语言对的原因。
- 模型规模。 NLLB-200 distilled 600M 能跑在笔记本上。NLLB-200 3.3B 是官方给出的生产默认值。54.5B 是研究上的天花板。
- 解码。 一般内容用 beam width 4-5。用长度惩罚避免输出过短。需要术语一致时使用约束解码。
构建它
步骤 1:调用预训练 MT 模型
pythonfrom transformers import AutoTokenizer, AutoModelForSeq2SeqLM
model_id = "facebook/nllb-200-distilled-600M"
tok = AutoTokenizer.from_pretrained(model_id, src_lang="eng_Latn")
model = AutoModelForSeq2SeqLM.from_pretrained(model_id)
src = "The cats are running."
inputs = tok(src, return_tensors="pt")
out = model.generate(
**inputs,
forced_bos_token_id=tok.convert_tokens_to_ids("fra_Latn"),
num_beams=5,
length_penalty=1.0,
max_new_tokens=64,
)
print(tok.batch_decode(out, skip_special_tokens=True)[0])textLes chats courent.这里有三件事很关键。src_lang 告诉分词器该按哪种文字和切分方式处理。forced_bos_token_id 告诉解码器生成哪种语言。两者都是 NLLB 专有的做法;mBART 和 M2M-100 各有自己的约定,不能互换。
步骤 2:BLEU 与 chrF
BLEU 衡量输出与参考译文之间的 n-gram 重叠。参考 n-gram 取 1 到 4 四种长度,对各阶精度的几何平均,再对过短的输出施加简短惩罚。分数范围是 [0, 100]。它被广泛使用,却很难解读:30 BLEU 算「可用」;40 算「好」;50 算「出色」;1 BLEU 以内的差异都是噪声。
chrF 衡量字符级 F 值。对形态丰富的语言更敏感——BLEU 在这类语言上会少算匹配。通常与 BLEU 一起报告。
pythonimport sacrebleu
hypotheses = ["Les chats courent."]
references = [["Les chats courent."]]
bleu = sacrebleu.corpus_bleu(hypotheses, references)
chrf = sacrebleu.corpus_chrf(hypotheses, references)
print(f"BLEU: {bleu.score:.1f} chrF: {chrf.score:.1f}")永远使用 sacrebleu。它会归一化分词,让不同论文之间的分数可比。自己手写 BLEU 计算,正是误导性基准的来源。
三层评估体系(2026)
现代 MT 评估使用三类互补的指标。上线时至少用其中两类。
- 启发式(BLEU、chrF)。快、基于参考、可解释,但对改写不敏感。用于历史对比和回归检测。
- 学习型(COMET、BLEURT、BERTScore)。在人类判断上训练的神经模型;比较译文与源文、参考文的语义相似度。自 2023 年以来,COMET 与 MT 研究结论的相关性最高;在质量重要的场景中,它是 2026 年的生产默认选择。
- LLM 作为评判者(无参考)。提示大模型从流畅度、充分性、语气、文化得体性等方面给译文打分。rubric 设计得当时,GPT-4-as-judge 与人类判断的一致率约为 80%。用于没有参考译文的开放式内容。
2026 年的实用组合:sacrebleu 算 BLEU 和 chrF,unbabel-comet 算 COMET,再用一个提示过的 LLM 提供最终面向人的信号。在生产数据上信任任何指标之前,先用 50-100 个人工标注样本校准它。
无参考指标(COMET-QE、BLEURT-QE、LLM-as-judge)让你在没有参考译文的情况下评估翻译,这对参考译文根本不存在的长尾语言对很重要。
步骤 3:生产里会出什么问题
上面这套可用的 pipeline,80% 的情况下会翻译得很流畅,剩下的 20% 会悄悄失败。以下是有名字的失败模式:
- 幻觉。 模型编造源文里没有的内容。在陌生的领域词汇上很常见。症状是:输出很流畅,却声称了源文没有陈述的事实。缓解办法:对领域术语做约束解码,对受监管内容进行人工审核,监控明显长于输入的输出。
- 目标语言跑偏。 模型翻译成了错误的目标语言。NLLB 在冷门语言对上出奇地容易犯这个错。缓解办法:确认
forced_bos_token_id,并始终用语言识别模型检查输出。 - 术语漂移。「Sign up」在第 1 篇文档里译成「s'inscrire」,在第 2 篇里变成「créer un compte」。对 UI 文案和面向用户的字符串来说,一致性比原始质量更重要。缓解办法:术语表约束解码,或后编辑词典。
- 正式度不匹配。 法语的「tu」与「vous」、日语的敬语层级。模型会选训练中更常见的那个形式。对面向客户的内容来说,这通常是错的。缓解办法:如果模型支持,在 prompt 前缀里加正式度 token;或者在仅含正式语料的语料上微调一个小模型。
- 短输入导致长度爆炸。 极短的输入句常常产生过长的译文,因为源文 token 少于约 5 个时,长度惩罚会断崖式失效。缓解办法:按源文长度设置硬性最大长度上限。
步骤 4:针对领域做微调
预训练模型是通才。法律、医学或游戏对话翻译,能从领域平行数据上的微调中获得可测量的收益。配方并不复杂:
pythonfrom transformers import Trainer, TrainingArguments
from datasets import Dataset
pairs = [
{"src": "The defendant pleaded guilty.", "tgt": "L'accusé a plaidé coupable."},
]
ds = Dataset.from_list(pairs)
def preprocess(ex):
return tok(
ex["src"],
text_target=ex["tgt"],
truncation=True,
max_length=128,
padding="max_length",
)
ds = ds.map(preprocess, remove_columns=["src", "tgt"])
args = TrainingArguments(output_dir="out", per_device_train_batch_size=4, num_train_epochs=3, learning_rate=3e-5)
Trainer(model=model, args=args, train_dataset=ds).train()几千条高质量平行样本,胜过多达几十万条嘈杂的网络抓取数据。训练数据的质量是生产中最大的单一杠杆。
使用它
2026 年的 MT 生产组合:
| 用例 | 推荐的起点 |
|---|---|
| 任意语言互译,200 种语言 | facebook/nllb-200-distilled-600M(笔记本)或 nllb-200-3.3B(生产) |
| 以英语为中心、高质量、50 种语言 | facebook/mbart-large-50-many-to-many-mmt |
| 短任务、低成本推理、英法/英德/英西 | Helsinki-NLP / Marian 模型 |
| 延迟敏感的浏览器端 | ONNX 量化的 Marian(约 50 MB) |
| 追求最高质量、愿意付费 | GPT-4 / Claude / Gemini 配合翻译 prompt |
到 2026 年,LLM 已在若干语言对上超过专用 MT 模型,尤其是在习语内容和长上下文上。代价是按 token 计费的成本和延迟。当上下文长度、风格一致性或通过 prompt 做领域适配比吞吐量更重要时,选 LLM。
交付它
保存为 outputs/skill-mt-evaluator.md:
markdown---
name: mt-evaluator
description: Evaluate a machine translation output for shipping.
version: 1.0.0
phase: 5
lesson: 11
tags: [nlp, translation, evaluation]
---
Given a source text and a candidate translation, output:
1. Automatic score estimate. BLEU and chrF ranges you would expect. State whether a reference is available.
2. Five-point human-verifiable check list: (a) content preservation (no hallucinations), (b) correct language, (c) register / formality match, (d) terminology consistency with glossary if provided, (e) no truncation or length explosion.
3. One domain-specific issue to probe. E.g., for legal: named entities and statute citations. For medical: drug names and dosages. For UI: placeholder variables `{name}`.
4. Confidence flag. "Ship" / "Ship with review" / "Do not ship". Tie to the severity of issues found in step 2.
Refuse to ship a translation without a language-ID check on output. Refuse to evaluate without a reference unless the user explicitly opts in to reference-free scoring (COMET-QE, BLEURT-QE). Flag any content over 1000 tokens as likely needing chunked translation.练习
- 简单。 用
nllb-200-distilled-600M把一段 5 句英文翻成法语,再翻回英语。衡量往返结果与原句的接近程度。你应该会看到语义保留,但用词发生漂移。 - 中等。 用
fasttext lid.176或langdetect对译文实现语言识别检查。集成到 MT 调用中,让目标语言跑偏的生成在返回前被拦下。 - 困难。 在你选定的 5,000 对领域语料上微调
nllb-200-distilled-600M。在留出集上测量微调前后的 BLEU。报告哪些类型的句子变好了,哪些退步了。
关键术语
| 术语 | 人们怎么说 | 实际含义 |
|---|---|---|
| BLEU | 翻译分数 | 带简短惩罚的 n-gram 精度。[0, 100]。 |
| chrF | 字符 F 值 | 字符级 F 值。对形态丰富的语言更敏感。 |
| NMT | 神经机器翻译 | 在平行语料上训练的 Transformer 编码器-解码器。2017 年以来的默认方案。 |
| NLLB | No Language Left Behind | Meta 的 200 语言 MT 模型家族。 |
| 约束解码 | 受控输出 | 强制特定 token 或 n-gram 出现或不出现。 |
| 幻觉 | 编造内容 | 不受源文支持的模型输出。 |
延伸阅读
- Costa-jussà et al. (2022). No Language Left Behind: Scaling Human-Centered Machine Translation——NLLB 论文。
- Post (2018). A Call for Clarity in Reporting BLEU Scores——为什么
sacrebleu是报告 BLEU 的唯一正确方式。 - Popović (2015). chrF: character n-gram F-score for automatic MT evaluation——chrF 论文。
- Hugging Face MT 指南——实用的微调流程。
示意图共 1 张