问题
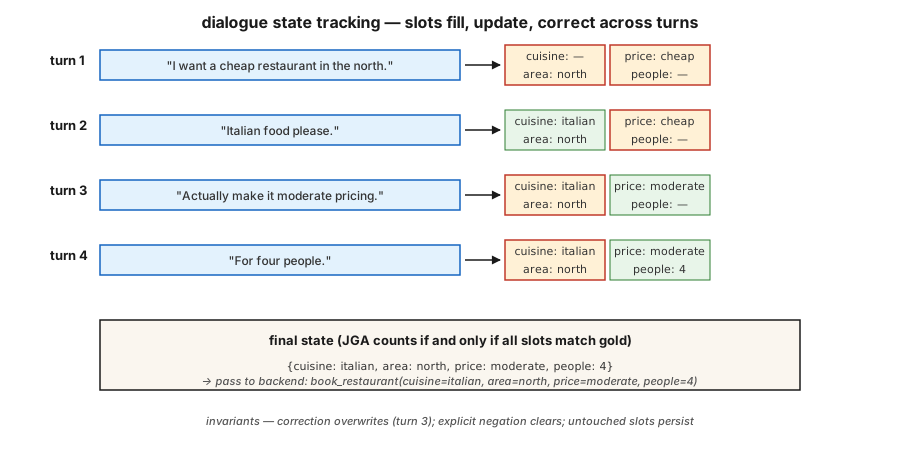
在任务型对话系统中,用户的目标被编码为一组 slot-value 对:{cuisine: italian, area: north, price: moderate}。用户的每一轮都可能新增、修改或删除某个 slot。系统必须读懂整段对话,并正确输出当前状态。
错一个 slot,系统就会订错餐厅、排错航班或扣错卡。DST 是用户所说内容与后端实际执行之间的枢纽。
有了 LLM,为什么 2026 年它仍然重要:
- 合规敏感领域(银行、医疗、机票预订)需要确定性的 slot 值,而不是自由生成的文本。
- 工具使用型 Agent 在调用 API 之前仍然需要解析 slot。
- 多轮纠正比看起来难:「actually no, make it Thursday.」
现代 pipeline:经典 DST 概念 + LLM 抽取器 + 结构化输出防护栏。
概念
任务结构。 schema 定义领域(餐厅、酒店、出租车)及其 slot(cuisine、area、price、people)。每个 slot 可以为空、取封闭集合中的值(price:{cheap, moderate, expensive}),或取自由形式的值(name:「The Copper Kettle」)。
两种 DST 形式化。
- 分类。 对每个 (slot, candidate_value) 对预测是/否。适用于封闭词表 slot,2020 年前的标准做法。
- 生成。 给定对话,以自由文本生成 slot 值。适用于开放词表 slot,现代默认做法。
指标。 Joint Goal Accuracy(JGA,联合目标准确率)——每个 slot 都正确的轮次占比。全有或全无。2026 年 MultiWOZ 2.4 排行榜的顶部在 83% 左右。
架构。
- 基于规则(slot 正则 + 关键词)。 窄领域的强基线,容易调试。
- TripPy / BERT-DST。 用 BERT 编码的复制式生成,LLM 之前的标准。
- LDST(LLaMA + LoRA)。 带领域-slot 提示的指令微调 LLM,在 MultiWOZ 2.4 上达到 ChatGPT 级质量。
- 无本体(2024–26)。 跳过 schema,直接生成 slot 名称和值,能处理开放领域。
- Prompt + 结构化输出(2024–26)。 LLM + Pydantic schema + 约束解码。5 行代码,即可上生产。
经典失败模式
- 跨轮共指。 「Let's stay with the first option.」需要解析出是哪个选项。
- 覆盖 vs. 追加。 用户说「add Italian.」你是替换 cuisine,还是追加?
- 隐式确认。 「OK cool」——这算接受了你提供的预订吗?
- 纠正。 「Actually make it 7 pm.」必须更新时间,同时不清除其他 slot。
- 指代上一轮系统话语。 「Yes, that one.」指的是哪个「that」?
构建它
步骤 1:基于规则的 slot 抽取器
见 code/main.py。正则 + 同义词词典可以覆盖窄领域中 70% 的典型表述:
pythonCUISINE_SYNONYMS = {
"italian": ["italian", "pasta", "pizza", "italy"],
"chinese": ["chinese", "chow mein", "noodles"],
}
def extract_cuisine(utterance):
for canonical, synonyms in CUISINE_SYNONYMS.items():
if any(syn in utterance.lower() for syn in synonyms):
return canonical
return None一旦超出典型词表就脆弱。适合确定性的 slot 确认。
步骤 2:状态更新循环
pythondef update_state(state, utterance):
new_state = dict(state)
for slot, extractor in SLOT_EXTRACTORS.items():
value = extractor(utterance)
if value is not None:
new_state[slot] = value
for slot in NEGATION_CLEARS:
if is_negated(utterance, slot):
new_state[slot] = None
return new_state三条不变式:
- 用户没有触碰的 slot 永远不要重置。
- 显式否定(「never mind the cuisine」)必须清空。
- 用户纠正(「actually...」)必须覆盖,而不是追加。
步骤 3:带结构化输出的 LLM 驱动 DST
pythonfrom pydantic import BaseModel
from typing import Literal, Optional
import instructor
class RestaurantState(BaseModel):
cuisine: Optional[Literal["italian", "chinese", "indian", "thai", "any"]] = None
area: Optional[Literal["north", "south", "east", "west", "center"]] = None
price: Optional[Literal["cheap", "moderate", "expensive"]] = None
people: Optional[int] = None
day: Optional[str] = None
def llm_dst(history, llm):
prompt = f"""You track the slot values of a restaurant booking across turns.
Dialogue so far:
{render(history)}
Update the state based on the latest user turn. Output only the JSON state."""
return llm(prompt, response_model=RestaurantState)Instructor + Pydantic 保证得到合法的状态对象。没有正则,没有 schema 不匹配,也不会有幻觉出来的 slot。
步骤 4:JGA 评估
pythondef joint_goal_accuracy(predicted_states, gold_states):
correct = sum(1 for p, g in zip(predicted_states, gold_states) if p == g)
return correct / len(predicted_states)校准:系统在多大比例的轮次里把所有 slot 都答对?在 MultiWOZ 2.4 上,2026 年最好的系统是 80-83%。你的领域内系统应该在窄词表上超过这个数字,否则 LLM 基线就会打败你。
步骤 5:处理纠正
pythonCORRECTION_CUES = {"actually", "no wait", "on second thought", "change that to"}
def is_correction(utterance):
return any(cue in utterance.lower() for cue in CORRECTION_CUES)检测到纠正时,覆盖最近更新的 slot,而不是追加。没有 LLM 帮忙很难做对。现代模式是:始终让 LLM 从历史重新生成整个状态,而不是增量更新——这样纠正会被自然处理。
常见陷阱
- 全历史重新生成的成本。 每轮都让 LLM 重新生成状态,总 token 成本为 O(n^2)。要限制历史长度或摘要较早的轮次。
- Schema 漂移。 事后新增 slot 会破坏旧的训练数据。给 schema 打版本。
- 大小写敏感。 「Italian」vs「italian」vs「ITALIAN」——处处都要归一化。
- 隐式继承。 如果用户之前说过「for 4 people」,新的换时间请求不应清掉 people。始终传入完整历史。
- 自由形式 vs. 封闭集合。 名称、时间、地址需要自由形式 slot;菜系和区域是封闭的。schema 中两种都要有。
使用它
2026 年的技术栈:
| 场景 | 方法 |
|---|---|
| 窄领域(一两个意图) | 基于规则 + 正则 |
| 宽领域,有标注数据 | LDST(在 MultiWOZ 风格数据上 LLaMA + LoRA) |
| 宽领域,无标注,可直接上生产 | LLM + Instructor + Pydantic schema |
| 语音场景 | ASR + 归一化器 + LLM-DST |
| 多领域预订流程 | 带按领域 Pydantic 模型的 schema 引导 LLM |
| 合规敏感 | 规则为主,LLM 兜底并带确认流程 |
交付它
保存为 outputs/skill-dst-designer.md:
markdown---
name: dst-designer
description: Design a dialogue state tracker — schema, extractor, update policy, evaluation.
version: 1.0.0
phase: 5
lesson: 29
tags: [nlp, dialogue, task-oriented]
---
Given a use case (domain, languages, vocab openness, compliance needs), output:
1. Schema. Domain list, slots per domain, open vs closed vocabulary per slot.
2. Extractor. Rule-based / seq2seq / LLM-with-Pydantic. Reason.
3. Update policy. Regenerate-whole-state / incremental; correction handling; negation handling.
4. Evaluation. Joint Goal Accuracy on a held-out dialogue set, slot-level precision/recall, confusion on the hardest slot.
5. Confirmation flow. When to explicitly ask the user to confirm (destructive actions, low-confidence extractions).
Refuse LLM-only DST for compliance-sensitive slots without a rule-based secondary check. Refuse any DST that cannot roll back a slot on user correction. Flag schemas without version tags.练习
- 简单。 在
code/main.py中为 3 个 slot(cuisine、area、price)构建基于规则的状态跟踪器。用 10 段手工构造的对话测试,测量 JGA。 - 中等。 在同一数据集上使用 Instructor + Pydantic + 小 LLM。比较 JGA,检查最难的轮次。
- 困难。 两种都实现并做路由:规则为主;当规则只抽出少于 2 个 slot 且置信度低时,用 LLM 兜底。测量组合 JGA 和每轮推理成本。
关键术语
| 术语 | 常见的说法 | 实际含义 |
|---|---|---|
| DST | 对话状态跟踪 | 跨对话轮次维护 slot-value 字典。 |
| Slot | 用户意图的单位 | 后端需要的具名参数(cuisine、date)。 |
| Domain | 任务领域 | 餐厅、酒店、出租车——slot 的集合。 |
| JGA | 联合目标准确率 | 每个 slot 都正确的轮次占比。全有或全无。 |
| MultiWOZ | 基准数据集 | 多领域 WOZ 数据集,DST 的标准评估集。 |
| 无本体 DST | 不要 schema | 直接生成 slot 名称和值,没有固定列表。 |
| 纠正 | 「Actually...」 | 会覆盖先前已填充 slot 的一轮。 |
延伸阅读
- Budzianowski et al. (2018). MultiWOZ — A Large-Scale Multi-Domain Wizard-of-Oz —— 经典基准。
- Feng et al. (2023). Towards LLM-driven Dialogue State Tracking (LDST) —— 面向 DST 的 LLaMA + LoRA 指令微调。
- Heck et al. (2020). TripPy — A Triple Copy Strategy for Value Independent Neural Dialog State Tracking —— 基于复制的 DST 主力模型。
- King, Flanigan (2024). Unsupervised End-to-End Task-Oriented Dialogue with LLMs —— 基于 EM 的无监督任务型对话。
- MultiWOZ leaderboard —— 标准 DST 结果。
示意图共 1 张