问题
一篇 2000 词的新闻稿推送到你的信息流里。你需要用 120 词概括它。你可以从文中挑出最重要的三句话(抽取式),也可以用自己的话重写内容(生成式,abstractive)。两者都叫摘要,却是完全不同的问题。
抽取式摘要是一个排序问题。给每个句子打分,返回得分最高的 k 句。输出永远语法正确,因为它是逐字摘出来的。风险在于漏掉分散在全文各处的信息。
生成式摘要是一个生成问题。Transformer 以输入为条件产生新文本。输出流畅、压缩,但可能幻觉出源文没有的事实。风险是自信的编造。
本课会把两种都构建出来,并各自配上它负责的失败模式。
概念
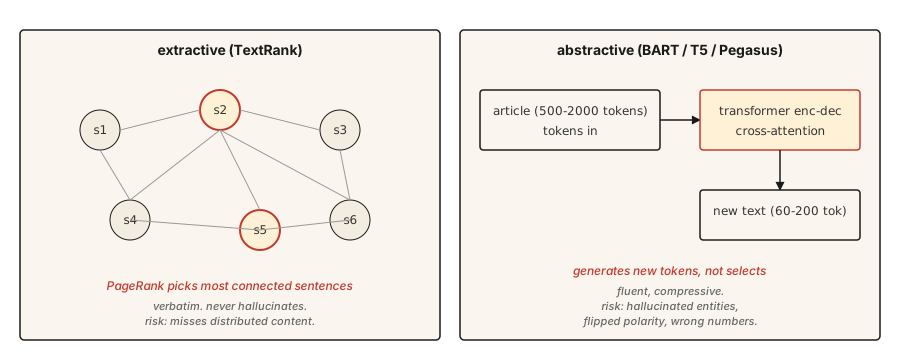
抽取式。 把文章看成一个图,节点是句子,边是相似度。在图上跑 PageRank(或类似算法),按句子与其他所有句子的连接程度打分。得分最高的句子就是摘要。经典实现是 TextRank(Mihalcea 和 Tarau,2004)。
生成式。 在文档-摘要对上微调 Transformer 编码器-解码器(BART、T5、Pegasus)。推理时,模型读入文档,通过交叉注意力逐 token 生成摘要。Pegasus 尤其使用了一种 gap-sentence 预训练目标,使得它无需太多微调就擅长摘要。
用 ROUGE(Recall-Oriented Understudy for Gisting Evaluation)评估。ROUGE-1 和 ROUGE-2 给 unigram 和 bigram 重叠打分。ROUGE-L 给最长公共子序列打分。越高越好,但 ROUGE-L 达到 40 就算「好」,50 算「出色」。每篇论文都会报告这三项。用 rouge-score 包。
构建它
步骤 1:TextRank(抽取式)
pythonimport math
import re
from collections import Counter
def sentence_split(text):
return re.split(r"(?<=[.!?])\s+", text.strip())
def similarity(s1, s2):
w1 = Counter(s1.lower().split())
w2 = Counter(s2.lower().split())
intersection = sum((w1 & w2).values())
denom = math.log(len(w1) + 1) + math.log(len(w2) + 1)
if denom == 0:
return 0.0
return intersection / denom
def textrank(text, top_k=3, damping=0.85, iterations=50, epsilon=1e-4):
sentences = sentence_split(text)
n = len(sentences)
if n <= top_k:
return sentences
sim = [[0.0] * n for _ in range(n)]
for i in range(n):
for j in range(n):
if i != j:
sim[i][j] = similarity(sentences[i], sentences[j])
scores = [1.0] * n
for _ in range(iterations):
new_scores = [1 - damping] * n
for i in range(n):
total_out = sum(sim[i]) or 1e-9
for j in range(n):
if sim[i][j] > 0:
new_scores[j] += damping * sim[i][j] / total_out * scores[i]
if max(abs(s - ns) for s, ns in zip(scores, new_scores)) < epsilon:
scores = new_scores
break
scores = new_scores
ranked = sorted(range(n), key=lambda k: scores[k], reverse=True)[:top_k]
ranked.sort()
return [sentences[i] for i in ranked]有两点值得点名。相似度函数使用对数归一化的词重叠,这是 TextRank 的原始变体。TF-IDF 向量的余弦相似度也可以。阻尼因子 0.85 和迭代次数都是 PageRank 的默认值。
步骤 2:用 BART 做生成式摘要
pythonfrom transformers import pipeline
summarizer = pipeline("summarization", model="facebook/bart-large-cnn")
article = """(long news article text)"""
summary = summarizer(article, max_length=120, min_length=60, do_sample=False)
print(summary[0]["summary_text"])BART-large-CNN 在 CNN/DailyMail 语料上微调过。它开箱就能生成新闻风格的摘要。其他领域(科学论文、对话、法律)应使用对应的 Pegasus checkpoint,或在你的目标数据上微调。
步骤 3:ROUGE 评估
pythonfrom rouge_score import rouge_scorer
scorer = rouge_scorer.RougeScorer(["rouge1", "rouge2", "rougeL"], use_stemmer=True)
scores = scorer.score(reference_summary, generated_summary)
print({k: round(v.fmeasure, 3) for k, v in scores.items()})始终启用词干化。不启用的话,「running」和「run」会被当成不同的词,ROUGE 会少算。
ROUGE 之外(2026 年的摘要评估)
ROUGE 统治摘要指标已经二十年,但在 2026 年,单靠它已经不够。一项针对 NLG 论文的大规模元分析显示:
- BERTScore(上下文 embedding 相似度)在 2023 年间不断扩大影响,如今大多数摘要论文会把它与 ROUGE 并列报告。
- BARTScore 把评估当作生成:用预训练 BART 在给定源文时赋予摘要的概率来打分。
- MoverScore(在上下文 embedding 上计算推土机距离)在 2025 年的摘要基准中登顶,因为它比 ROUGE 更好地捕捉语义重叠。
- FactCC 和基于 QA 的忠实度在 2021-2023 年很常见,现在常被 G-Eval 取代(一条 GPT-4 prompt 链,用思维链推理给连贯性、一致性、流畅度、相关性打分)。
- rubric 设计得当时,G-Eval 及类似的 LLM 评判方法与人类判断的一致率约为 80%。
生产建议:报告 ROUGE-L 用于历史对比,BERTScore 用于语义重叠,G-Eval 用于连贯性和事实性。用 50-100 个人工标注摘要做校准。
步骤 4:事实性问题
生成式摘要容易产生幻觉。抽取式摘要的幻觉风险低得多,因为输出是从源文逐字摘出的;不过如果源句被去掉了上下文、已经过时,或被乱序引用,它仍可能误导。这就是生产系统在合规相关内容上仍然偏爱抽取式方法的最大原因。
值得点名的幻觉类型:
- 实体替换。 源文说「John Smith」,摘要说「John Brown」。
- 数字漂移。 源文说「25,000」,摘要说「25 million」。
- 极性翻转。 源文说「拒绝了提议」,摘要说「接受了提议」。
- 事实编造。 源文没提 CEO,摘要却说 CEO 批准了。
有效的评估方法:
- FactCC。 一个在源句与摘要句之间的蕴含关系上训练的二分类器。预测是否有事实依据。
- 基于 QA 的事实性。 向 QA 模型提问,答案在源文中。如果摘要支持不同的答案,就标记出来。
- 实体级 F1。 比较源文与摘要中的命名实体。只出现在摘要里的实体值得怀疑。
对任何面向用户且事实性重要的内容(新闻、医疗、法律、金融),抽取式是更安全的默认选择。生成式则需要在流程中加一道事实性检查。
使用它
2026 年的技术栈:
| 用例 | 推荐 |
|---|---|
| 新闻,3-5 句摘要,英文 | facebook/bart-large-cnn |
| 科学论文 | google/pegasus-pubmed 或调过的 T5 |
| 多文档、长文本 | 任何 32k+ 上下文的 LLM,配合提示 |
| 对话摘要 | philschmid/bart-large-cnn-samsum |
| 抽取式,构造上就低幻觉风险 | TextRank 或 sumy 的 LSA / LexRank |
2026 年,算力不受限时,长上下文 LLM 常常胜过专用模型。代价是成本和可复现性;专用模型的输出更一致。
交付它
保存为 outputs/skill-summary-picker.md:
markdown---
name: summary-picker
description: Pick extractive or abstractive, named library, factuality check.
version: 1.0.0
phase: 5
lesson: 12
tags: [nlp, summarization]
---
Given a task (document type, compliance requirement, length, compute budget), output:
1. Approach. Extractive or abstractive. Explain in one sentence why.
2. Starting model / library. Name it. `sumy.TextRankSummarizer`, `facebook/bart-large-cnn`, `google/pegasus-pubmed`, or an LLM prompt.
3. Evaluation plan. ROUGE-1, ROUGE-2, ROUGE-L (use rouge-score with stemming). Plus factuality check if abstractive.
4. One failure mode to probe. Entity swap is the most common in abstractive news summarization; flag samples where source entities do not appear in summary.
Refuse abstractive summarization for medical, legal, financial, or regulated content without a factuality gate. Flag input over the model's context window as needing chunked map-reduce summarization (not just truncation).练习
- 简单。 在 5 篇新闻上运行 TextRank。把前 3 句与参考摘要对比。测量 ROUGE-L。在 CNN/DailyMail 风格的新闻上,你应该会看到 30-45 的 ROUGE-L。
- 中等。 实现实体级事实性:从源文和摘要中抽取命名实体(spaCy),计算源文实体在摘要中的召回率,以及摘要实体相对源文的精度。高精度低召回意味着安全但简略;低精度意味着有幻觉实体。
- 困难。 在 50 篇 CNN/DailyMail 文章上比较 BART-large-CNN 与 LLM(Claude 或 GPT-4)。报告 ROUGE-L、事实性(按实体 F1)以及每篇摘要的成本。记录各自在哪些方面胜出。
关键术语
| 术语 | 人们怎么说 | 实际含义 |
|---|---|---|
| 抽取式 | 挑句子 | 逐字返回源文中的句子。绝不会幻觉。 |
| 生成式 | 重写 | 以源文为条件生成新文本。可能幻觉。 |
| ROUGE | 摘要指标 | 系统输出与参考之间的 n-gram / LCS 重叠。 |
| TextRank | 基于图的抽取式 | 在句子相似度图上跑 PageRank。 |
| 事实性 | 对不对 | 摘要中的说法是否有源文支持。 |
| 幻觉 | 编出来的内容 | 摘要中源文不支持的内容。 |
延伸阅读
- Mihalcea and Tarau (2004). TextRank: Bringing Order into Texts——抽取式摘要的经典论文。
- Lewis et al. (2019). BART: Denoising Sequence-to-Sequence Pre-training——BART 论文。
- Zhang et al. (2019). PEGASUS: Pre-training with Extracted Gap-sentences——Pegasus 与 gap-sentence 目标。
- Lin (2004). ROUGE: A Package for Automatic Evaluation of Summaries——ROUGE 论文。
- Maynez et al. (2020). On Faithfulness and Factuality in Abstractive Summarization——事实性全景论文。
示意图共 1 张