问题
一个分类器向 LLM 发出提示:「返回 {positive, negative, neutral} 之一。」模型返回的是:「情感是 positive —— 这条评论压倒性地正面,因为顾客明确表示他们……」。你的解析器崩溃了。分类器的 F1 是 0.0。
自由形式的生成不是契约,只是建议。生产系统需要契约。
2026 年存在三个层次。
- Prompt。 好好请求。「只返回 JSON 对象。」在前沿模型上约 80% 有效,小模型上更低。
- 原生结构化输出 API。 OpenAI 的
response_format、Anthropic 的 tool use、Gemini 的 JSON 模式。在支持的 schema 上可靠。但被厂商锁定。 - 约束解码。 在每个生成步骤修改 logit,使模型无法输出非法 token。从构造上保证 100% 合法。适用于任何本地模型。
本节课帮你建立对这三层的直觉,并说明何时该用哪一种。
概念
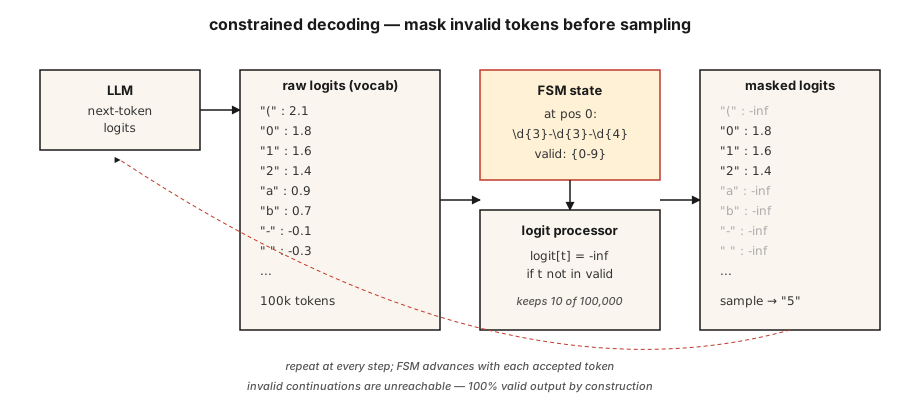
约束解码的工作原理。 每个生成步骤中,LLM 都会在整个词表(约 100k 个 token)上产生一个 logit 向量。logit 处理器位于模型和采样器之间。它根据目标文法(JSON Schema、正则、上下文无关文法)中的当前位置,计算哪些 token 是合法的,并把所有非法 token 的 logit 设为负无穷。对剩余 logit 做 softmax,概率质量就只会落在合法的延续上。
2026 年的实现:
- Outlines。 把 JSON Schema 或正则编译成有限状态机。每个 token 都有 O(1) 的合法下一 token 查询。基于 FSM,因此递归 schema 需要展平。
- XGrammar / llguidance。 上下文无关文法引擎。能处理递归 JSON Schema。解码开销接近零。OpenAI 在 2025 年的结构化输出实现中致谢了 llguidance。
- vLLM guided decoding。 内置
guided_json、guided_regex、guided_choice、guided_grammar,后端可选 Outlines、XGrammar 或 lm-format-enforcer。 - Instructor。 基于 Pydantic 的包装层,可套在任何 LLM 上。校验失败时重试。跨厂商,但不修改 logit —— 它依赖重试加能识别结构化输出的 prompt。
反直觉的结果
约束解码常常比无约束生成更快。原因有两个。第一,它缩小了下一 token 的搜索空间。第二,聪明的实现会对被强制的 token 完全跳过生成(像 {"name": " 这样的骨架,每个字节都是确定的)。
让你付出代价的陷阱
字段顺序很重要。把 answer 放在 reasoning 前面,模型就会先给出答案再思考。JSON 是合法的。答案是错的。没有任何校验能抓住这个问题。
json// BAD
{"answer": "yes", "reasoning": "because ..."}
// GOOD
{"reasoning": "... therefore ...", "answer": "yes"}Schema 字段顺序是逻辑,不是格式。
构建它
第 1 步:从零实现正则约束生成
完整独立的 FSM 实现见 code/main.py。核心思想用 30 行就能说清:
pythondef mask_logits(logits, valid_token_ids):
mask = [float("-inf")] * len(logits)
for tid in valid_token_ids:
mask[tid] = logits[tid]
return mask
def generate_constrained(model, tokenizer, prompt, fsm):
ids = tokenizer.encode(prompt)
state = fsm.initial_state
while not fsm.is_accept(state):
logits = model.next_token_logits(ids)
valid = fsm.valid_tokens(state, tokenizer)
logits = mask_logits(logits, valid)
tok = sample(logits)
ids.append(tok)
state = fsm.transition(state, tok)
return tokenizer.decode(ids)FSM 跟踪我们目前已经满足文法的哪些部分。valid_tokens(state, tokenizer) 计算哪些词表 token 能推进 FSM 且不会离开可接受路径。
第 2 步:用 Outlines 处理 JSON Schema
pythonfrom pydantic import BaseModel
from typing import Literal
import outlines
class Review(BaseModel):
sentiment: Literal["positive", "negative", "neutral"]
confidence: float
evidence_span: str
model = outlines.models.transformers("meta-llama/Llama-3.2-3B-Instruct")
generator = outlines.generate.json(model, Review)
result = generator("Classify: 'The wait staff was attentive and the food arrived hot.'")
print(result)
# Review(sentiment='positive', confidence=0.93, evidence_span='attentive ... hot')零校验错误。永远如此。FSM 让非法输出不可达。
第 3 步:用 Instructor 实现与厂商无关的 Pydantic
pythonimport instructor
from anthropic import Anthropic
from pydantic import BaseModel, Field
class Invoice(BaseModel):
vendor: str
total_usd: float = Field(ge=0)
line_items: list[str]
client = instructor.from_anthropic(Anthropic())
invoice = client.messages.create(
model="claude-opus-4-7",
max_tokens=1024,
response_model=Invoice,
messages=[{"role": "user", "content": "Extract from: 'Acme Corp $420. Widget, Gizmo.'"}],
)机制不同。Instructor 不碰 logit。它把 schema 格式化进 prompt,解析输出,校验失败时重试(默认 3 次)。适用于任何厂商。重试会增加延迟和成本。跨厂商可移植性是它的卖点。
第 4 步:厂商原生 API
pythonfrom openai import OpenAI
client = OpenAI()
response = client.responses.create(
model="gpt-5",
input=[{"role": "user", "content": "Classify: 'The food was cold.'"}],
text={"format": {"type": "json_schema", "name": "sentiment",
"schema": {"type": "object", "required": ["sentiment"],
"properties": {"sentiment": {"type": "string",
"enum": ["positive", "negative", "neutral"]}}}}},
)
print(response.output_parsed)服务端约束解码。在支持的 schema 上与 Outlines 可靠性相当。无需管理本地模型。但会把你锁在该厂商上。
陷阱
- 递归 schema。 Outlines 会把递归展平到固定深度。树形结构输出(嵌套评论、AST)需要 XGrammar 或 llguidance(基于 CFG)。
- 巨大的枚举。 10,000 个选项的枚举编译很慢甚至会超时。改用检索器:先预测 top-k 候选,再约束到这些候选。
- 文法太严格。 强制
date: "YYYY-MM-DD"正则后,模型无法为缺失日期输出"unknown"。模型会编造一个日期来补偿。允许null或哨兵值。 - 过早承诺。 见上面的字段顺序陷阱。始终把 reasoning 放在前面。
- 没有 schema 的厂商 JSON 模式。 纯 JSON 模式只保证 JSON 语法合法,不保证对你的用例合法。始终提供完整 schema。
使用它
2026 年的技术栈:
| 场景 | 选择 |
|---|---|
| OpenAI/Anthropic/Google 模型,简单 schema | 厂商原生结构化输出 |
| 任意厂商,Pydantic 工作流,可容忍重试 | Instructor |
| 本地模型,需要 100% 合法,扁平 schema | Outlines(FSM) |
| 本地模型,递归 schema | XGrammar 或 llguidance |
| 自托管推理服务器 | vLLM guided decoding |
| 批处理,可接受重试 | Instructor + 最便宜的模型 |
交付它
保存为 outputs/skill-structured-output-picker.md:
markdown---
name: structured-output-picker
description: Choose a structured output approach, schema design, and validation plan.
version: 1.0.0
phase: 5
lesson: 20
tags: [nlp, llm, structured-output]
---
Given a use case (provider, latency budget, schema complexity, failure tolerance), output:
1. Mechanism. Native vendor structured output, Instructor retries, Outlines FSM, or XGrammar CFG. One-sentence reason.
2. Schema design. Field order (reasoning first, answer last), nullable fields for "unknown", enum vs regex, required fields.
3. Failure strategy. Max retries, fallback model, graceful `null` handling, out-of-distribution refusal.
4. Validation plan. Schema compliance rate (target 100%), semantic validity (LLM-judge), field-coverage rate, latency p50/p99.
Refuse any design that puts `answer` or `decision` before reasoning fields. Refuse to use bare JSON mode without a schema. Flag recursive schemas behind an FSM-only library.练习
- 简单。 在不使用约束解码的情况下,让小规模开放权重模型(如 Llama-3.2-3B)输出
Review(sentiment, confidence, evidence_span)。在 100 条评论上测量能解析为合法 JSON 的比例。 - 中等。 同一语料改用 Outlines 的 JSON 模式。比较合规率、延迟和语义准确率。
- 困难。 从零实现一个针对电话号码(
\d{3}-\d{3}-\d{4})的正则约束解码器。在 1000 个样本上验证 0 个非法输出。
关键术语
| 术语 | 大家常说的 | 实际含义 |
|---|---|---|
| 约束解码 | 强制输出合法 | 在每个生成步骤屏蔽非法 token 的 logit。 |
| logit 处理器 | 做约束的那个东西 | 函数:(logits, state) -> masked_logits。 |
| FSM | 有限状态机 | 编译后的文法表示;O(1) 的合法下一 token 查询。 |
| CFG | 上下文无关文法 | 能处理递归的文法;比 FSM 慢,但表达力更强。 |
| Schema 字段顺序 | 重要吗? | 重要 —— 第一个字段就定调;始终把 reasoning 放在 answer 前面。 |
| Guided decoding | vLLM 的叫法 | 同一概念,集成进了推理服务器。 |
| JSON 模式 | OpenAI 的早期版本 | 保证 JSON 语法;不保证符合 schema。 |
延伸阅读
- Willard, Louf (2023). Efficient Guided Generation for LLMs —— Outlines 论文。
- XGrammar paper (2024) —— 基于 CFG 的快速约束解码。
- vLLM — Structured Outputs —— 推理服务器集成。
- OpenAI — Structured Outputs guide —— API 参考 + 注意事项。
- Instructor library —— 跨厂商的 Pydantic + 重试。
- JSONSchemaBench (2025) —— 对 6 个约束解码框架做基准测试。
示意图共 1 张