问题
你有一份 200 页的合同。模型声称支持 100 万 token 上下文。你把合同贴进去,问:「终止条款是什么?」模型回答了——但答的是封面页的内容,因为终止条款位于 12 万 token 深处,超出了模型真正关注的区域。
这就是 2026 年的上下文容量鸿沟。规格表写 1M 或 10M,现实是其中 60-70% 可用,而且「可用」取决于任务。
- 检索(草堆中的单根针): 在前沿模型上,直到宣称的最大长度都接近完美。
- 多跳 / 聚合: 在大多数模型上,超过约 128k 后急剧退化。
- 基于分散事实的推理: 最先失败的任务。
长上下文评估测量这些维度。本课介绍各基准的名称、它们实际测量什么,以及如何为你的领域构建自定义的针测试。
概念
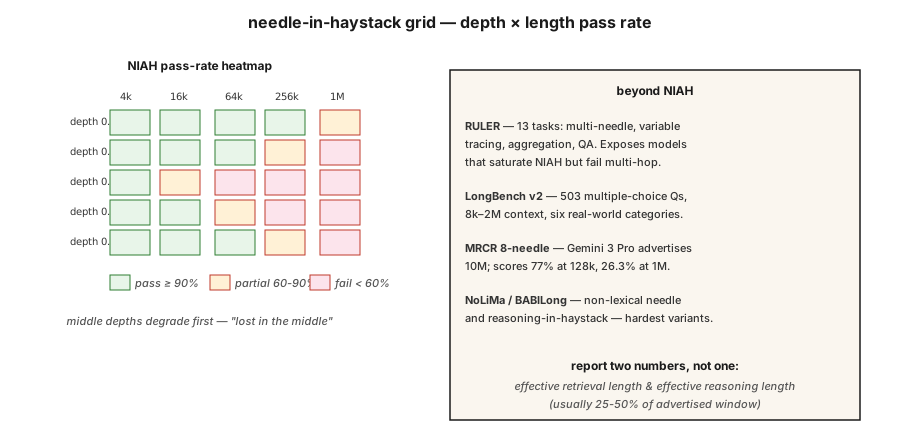
Needle-in-a-Haystack(NIAH,2023,草堆寻针)。 把一条事实(「the magic word is pineapple」)放在长上下文中的受控深度,让模型检索它。扫描深度 × 长度。这是最早的长上下文基准。前沿模型现在已经能打满,所以它是必要但不充分的基线。
RULER(Nvidia,2024)。 4 大类共 13 种任务:检索(单键 / 多键 / 多值)、多跳追踪(变量追踪)、聚合(常见词频率)、问答。上下文长度可配置(4k 到 128k+)。它能揭示那些 NIAH 打满却在多跳上失败的模型。在 2024 年的发布中,17 个声称支持 32k+ 上下文的模型里,只有一半在 32k 时保持了质量。
LongBench v2(2024)。 503 道多项选择题,上下文长度 8k-2M 词,六个任务类别:单文档 QA、多文档 QA、长上下文学习、长对话、代码仓库、长结构化数据。这是衡量真实世界长上下文行为的生产级基准。
MRCR(Multi-Round Coreference Resolution,多轮共指消解)。 大规模多轮共指。有 8-needle、24-needle、100-needle 三种变体,用来暴露模型在注意力退化前能同时处理多少条事实。
NoLiMa。 「非词汇针」。针和查询之间没有字面重叠,检索需要一步语义推理。比 NIAH 更难。
HELMET。 拼接多篇文档,就其中任意一篇提问。测试选择性注意力。
BABILong。 把 bAbI 推理链嵌入无关的草堆中。测试的是「草堆中的推理」,而不只是检索。
实际应该报告什么
- 宣称的上下文窗口。 规格表上的数字。
- 有效检索长度。 在某个阈值(例如 90%)下通过 NIAH 的长度。
- 有效推理长度。 在该阈值下通过多跳或聚合任务的长度。
- 退化曲线。 按任务类型绘制的准确率 vs 上下文长度曲线。
你的规格表上应该写两个数字:有效检索长度和有效推理长度。通常有效推理长度只有宣称窗口的 25-50%。
构建它
步骤 1:为你的领域定制 NIAH
见 code/main.py。骨架如下:
pythondef build_haystack(filler_text, needle, depth_ratio, total_tokens):
if not (0.0 <= depth_ratio <= 1.0):
raise ValueError(f"depth_ratio must be in [0, 1], got {depth_ratio}")
if total_tokens <= 0:
raise ValueError(f"total_tokens must be positive, got {total_tokens}")
filler_tokens = tokenize(filler_text)
needle_tokens = tokenize(needle)
if not filler_tokens:
raise ValueError("filler_text produced no tokens")
# Repeat filler until long enough to fill the haystack body.
body_len = max(total_tokens - len(needle_tokens), 0)
while len(filler_tokens) < body_len:
filler_tokens = filler_tokens + filler_tokens
filler_tokens = filler_tokens[:body_len]
insert_at = min(int(body_len * depth_ratio), body_len)
haystack = filler_tokens[:insert_at] + needle_tokens + filler_tokens[insert_at:]
return " ".join(haystack)
def score_niah(model, haystack, question, expected):
answer = model.complete(f"Context: {haystack}\nQ: {question}\nA:", max_tokens=50)
return 1 if expected.lower() in answer.lower() else 0扫描 depth_ratio ∈ {0, 0.25, 0.5, 0.75, 1.0} × total_tokens ∈ {1k, 4k, 16k, 64k},画出热力图。这就是目标模型的 NIAH 卡片。
步骤 2:多针变体
pythondef build_multi_needle(filler, needles, total_tokens):
depths = [0.1, 0.4, 0.7]
chunks = [filler[:int(total_tokens * 0.1)]]
for depth, needle in zip(depths, needles):
chunks.append(needle)
next_chunk = filler[int(total_tokens * depth): int(total_tokens * (depth + 0.3))]
chunks.append(next_chunk)
return " ".join(chunks)像「What are the three magic words?」这样的问题需要把三根针全部检索出来。单针成功不能预测多针成功。
步骤 3:多跳变量追踪(RULER 风格)
pythonhaystack = """X1 = 42. ... (filler) ... X2 = X1 + 10. ... (filler) ... X3 = X2 * 2."""
question = "What is X3?"答案需要串联三个赋值。前沿模型在 128k 时,这里的准确率常常掉到 50-70%。
步骤 4:在你的技术栈上跑 LongBench v2
pythonfrom datasets import load_dataset
longbench = load_dataset("THUDM/LongBench-v2")
def eval_model_on_longbench(model, subset="single-doc-qa"):
tasks = [x for x in longbench["test"] if x["task"] == subset]
correct = 0
for x in tasks:
answer = model.complete(x["context"] + "\n\nQ: " + x["question"], max_tokens=20)
if normalize(answer) == normalize(x["answer"]):
correct += 1
return correct / len(tasks)按类别报告准确率。聚合分数会掩盖巨大的任务级差异。
常见陷阱
- 只做 NIAH 评估。 在 100 万 token 上通过 NIAH 说明不了多跳能力。一定要跑 RULER 或自定义多跳测试。
- 单一深度采样。 很多实现只测 depth=0.5。要测 depth=0、0.25、0.5、0.75、1.0——「lost in the middle」效应是真实存在的。
- 针与填充文本词汇重叠。 如果针与填充文本共享关键词,检索就变得太容易。用 NoLiMa 风格的不重叠针。
- 忽略延迟。 100 万 token 的 prompt 预填充需要 30-120 秒。测量准确率的同时也要测首 token 时间。
- 厂商自报数字。 OpenAI、Google、Anthropic 都会发布自己的分数。一定要在你的用例上独立复测。
使用它
2026 年的技术栈:
| 场景 | 基准 |
|---|---|
| 快速健全性检查 | 3 个深度 × 3 个长度的自定义 NIAH |
| 生产环境模型选型 | 在目标长度上跑 RULER(13 项任务) |
| 真实世界 QA 质量 | LongBench v2 单文档 QA 子集 |
| 多跳推理 | BABILong 或自定义变量追踪 |
| 对话场景 | 目标长度上的 MRCR 8-needle |
| 模型升级回归 | 固定的内部 NIAH + RULER 测试框架,每个新模型都跑 |
生产经验法则:在你打算使用的长度上跑完 NIAH + 1 个推理任务之前,永远不要相信一个上下文窗口。
交付它
保存为 outputs/skill-long-context-eval.md:
markdown---
name: long-context-eval
description: Design a long-context evaluation battery for a given model and use case.
version: 1.0.0
phase: 5
lesson: 28
tags: [nlp, long-context, evaluation]
---
Given a target model, target context length, and use case, output:
1. Tests. NIAH depth × length grid; RULER multi-hop; custom domain task.
2. Sampling. Depths 0, 0.25, 0.5, 0.75, 1.0 at each length.
3. Metrics. Retrieval pass rate; reasoning pass rate; time-to-first-token; cost-per-query.
4. Cutoff. Effective retrieval length (90% pass) and effective reasoning length (70% pass). Report both.
5. Regression. Fixed harness, rerun on every model upgrade, surface deltas.
Refuse to trust a context window from the model card alone. Refuse NIAH-only evaluation for any multi-hop workload. Refuse vendor self-reported long-context scores as independent evidence.练习
- 简单。 构建 3 个深度(0.25、0.5、0.75)× 3 个长度(1k、4k、16k)的 NIAH。在任意模型上运行,把通过率画成 3×3 热力图。
- 中等。 增加 3-needle 变体。测量每个长度下 3 根针全部检索到的比例,与同长度下的单针通过率对比。
- 困难。 构造一个变量追踪任务(X1 → X2 → X3,3 跳),嵌入 64k 填充文本中。在 3 个前沿模型上测量准确率,报告每个模型的有效推理长度。
关键术语
| 术语 | 常见的说法 | 实际含义 |
|---|---|---|
| NIAH | 草堆寻针 | 把事实埋进填充文本,让模型检索。 |
| RULER | 加强版 NIAH | 覆盖检索 / 多跳 / 聚合 / QA 的 13 种任务。 |
| 有效上下文 | 真实容量 | 准确率仍保持在阈值之上的长度。 |
| Lost in the middle | 深度偏差 | 模型对长输入中间的内容关注不足。 |
| 多针 | 一次多条事实 | 埋多根针;测试注意力同时处理多项的能力,而不只是检索。 |
| MRCR | 多轮共指 | 8、24 或 100 needle 的共指;暴露注意力饱和。 |
| NoLiMa | 非词汇针 | 针与查询没有字面共享 token;需要推理。 |
延伸阅读
- Kamradt (2023). Needle in a Haystack analysis —— NIAH 的原始仓库。
- Hsieh et al. (2024). RULER: What's the Real Context Size of Your Long-Context LMs? —— 多任务基准。
- Bai et al. (2024). LongBench v2 —— 真实世界长上下文评估。
- Modarressi et al. (2024). NoLiMa: Non-lexical needles —— 更难的针。
- Kuratov et al. (2024). BABILong —— 草堆中的推理。
- Liu et al. (2024). Lost in the Middle: How Language Models Use Long Contexts —— 深度偏差论文。
示意图共 1 张